Claude
 Cursor
 Codex
 Hugging Face
 NVIDIA
 Visual Studio Code
 Devin
 Kiro
 Open Code
 NanoClaw

 Docker
 npm
 PyPy
 Wiz

 Financial Services
 Gaming
 Public Sector
 Automotive
 Technology
 Healthcare


Definition
Q-Learning ist ein modellfreier Reinforcement-Learning-Algorithmus (RL), mit dem Agenten optimale Aktionen bestimmen, indem sie eine Q-Table mit erwarteten zukünftigen Rewards iterativ aktualisieren. Dieser wertbasierte Ansatz ermöglicht es Maschinen, komplexe sequenzielle Entscheidungsprobleme zu lösen, ohne ein vordefiniertes Modell der Umgebungsdynamik zu benötigen. Mithilfe der Bellman-Gleichung können Unternehmen mathematisch fundierte Richtlinien für Robotik und Netzwerkoptimierung ableiten, vorausgesetzt, sie halten sich an strenge Regeln zur Verwaltung von Artefakten.
h2>Was sind die zentralen algorithmischen Merkmale von Q-Learning?
Q-Learning zeichnet sich durch drei zentrale algorithmische Merkmale aus:
- Modellfrei: Der Algorithmus benötigt weder ein komplexes Übergangsmodell noch Vorwissen über die Umgebungsdynamik.
- Wertbasiert: Er optimiert iterativ eine diskrete Wertfunktion – die Q-Funktion –, die das Verhalten eindeutig bestimmt.
- Off-Policy: Die Behavior Policy, mit der die Umgebung während des Trainings erkundet wird, unterscheidet sich vollständig von der Update Policy, die gelernt und mathematisch optimiert wird.
Q-Learning wurde 1989 von Watkins eingeführt. Klassisches Q-Learning lieferte die grundlegenden Mechanismen, die letztlich zu den heutigen Erfolgen im Deep Reinforcement Learning führten, und prägte maßgeblich Entwicklungen wie AlphaGo und moderne Verfahren des Reinforcement Learning from Human Feedback (RLHF).
Was sind die Bausteine von Q-Learning?
Ein fundiertes Verständnis von Q-Learning setzt voraus, die mathematischen und konzeptionellen Elemente zu kennen, aus denen ein Markov-Entscheidungsprozess besteht. Diese Bausteine legen die Regeln für das Zusammenspiel zwischen dem Lernalgorithmus und seiner Umgebung fest.
Das mathematische Grundgerüst von Q-Learning ist der Markov Decision Process (MDP). Ein MDP ist formal als Tupel definiert, bestehend aus Zuständen, zulässigen Aktionen, Übergangswahrscheinlichkeiten, Rewards der Umgebung und einem mathematischen Discount-Faktor. Dieses Framework basiert auf der Markov-Eigenschaft, nach der der zukünftige Zustand ausschließlich vom aktuellen Zustand und der aktuellen Aktion abhängt, unabhängig von allen vorherigen Zuständen.
Zentrale Elemente der Berechnung
Innerhalb dieses formalen Frameworks wirken mehrere zentrale Elemente zusammen:
- Agent: Die autonome, entscheidungsfähige Recheneinheit, die fortlaufend Zustände beobachtet und passende Aktionen auswählt.
- Umgebung (Environment): Die externe mathematische Welt, in der der Agent agiert. Die Umgebung verarbeitet Aktionen und gibt unmittelbare Rewards sowie Folgezustände zurück.
- Zustand (s): Die konkrete, beobachtbare aktuelle Situation des Agenten in der aktiven Umgebung.
- Aktion (a): Die konkrete, diskrete Entscheidung, die der Agent in einem bestimmten Zustand ausführt.
- Reward (r): Das unmittelbare skalare Feedback-Signal, das die Umgebung direkt nach einer ausgeführten Aktion zurückgibt.
- Episode: Ein vollständiger, sequenzieller Durchlauf von Zuständen, Aktionen und Rewards, der in einem initialisierten Startzustand beginnt und in einem definierten Endzustand endet.
- Q-Wert (Q(s,a)): Der berechnete erwartete kumulative zukünftige Reward, wenn im Zustand s die Aktion a ausgeführt wird und der Agent anschließend die optimale Richtlinie befolgt.
h2>So funktioniert Q-Learning: die Update-Regel
Die Ausführung von Q-Learning basiert auf einem iterativen mathematischen Update, der sogenannten Bellman-Gleichung, die den erwarteten Wert von Aktionen kontinuierlich verfeinert. Dieser dynamische Prozess wägt fortlaufend das unmittelbare Feedback der Umgebung gegen den prognostizierten langfristigen Nutzen nachfolgender Zustände ab.
Der klassische Q-Learning-Algorithmus speichert die gelernten Q-Werte in einer Datenstruktur, der sogenannten Q-Tabelle. In dieser Matrix stehen die Zeilen für alle möglichen beobachtbaren Zustände, die Spalten für alle zulässigen Aktionen, und die einzelnen Zellen enthalten die mathematisch erwarteten zukünftigen Rewards für das jeweilige Zustand-Aktion-Paar. Vor dem Training wird diese Tabelle in der Regel mit Nullen initialisiert.
In jedem Schritt beobachtet der Agent den aktuellen Zustand, wählt eine Aktion aus und erhält einen skalaren Reward sowie den neuen Zustand. Anschließend aktualisiert er den entsprechenden Eintrag in der Q-Tabelle mithilfe der Update-Regel der Bellman-Gleichung:
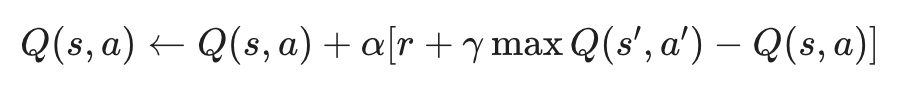
Hyperparameter und Explorationsstrategien
Während des Trainings steuert der Agent den Trade-off zwischen Exploration und Exploitation gezielt mit einer ε-Greedy-Strategie. Mit der Wahrscheinlichkeit ε führt der Agent eine vollständig zufällige Aktion aus, um die Umgebung aktiv zu erkunden. Mit der Wahrscheinlichkeit 1-ε wählt er dagegen die Aktion mit dem höchsten bekannten Q-Wert, um sein aktuelles Wissen aus der Matrix gezielt zu nutzen. Der Parameter ε nimmt im Verlauf des Trainings ab, während die Q-Werte zuverlässig konvergieren. Bei ausreichender Exploration aller möglichen Zustand-Aktion-Paare konvergieren Q-Learning-Algorithmen mathematisch garantiert zur optimalen Policy.
Diese Methode des Temporal Difference Learning ist auf sorgfältig abgestimmte Hyperparameter angewiesen. Die Lernrate (a), die typischerweise zwischen 0,1 und 0,7 liegt, steuert, wie schnell neue Informationen aus der Umgebung ältere Wertschätzungen überschreiben. Der Discount-Faktor (γ), der zwischen 0 und 1 liegt, bestimmt, wie stark der Agent gewichtet.
Q-Tabelle vs. Funktionsapproximation
Der tabellarische Ansatz von Q-Learning garantiert zwar Konvergenz in endlichen Umgebungen, stößt jedoch bei komplexen, hochdimensionalen Zustandsräumen schnell an Skalierungsgrenzen. Funktionsapproximation löst dieses Problem, indem sie die vollständige Q-Tabelle durch parametrisierte Modelle wie neuronale Netze ersetzt.
Die größte technische Stärke einer klassischen Q-Tabelle liegt in ihrer Einfachheit bei der Implementierung und ihrer klaren Interpretierbarkeit sowie in ihren absoluten Konvergenzgarantien in kleinen, diskreten Umgebungen. Allerdings stößt die Q-Tabelle aufgrund der Explosion des Zustandsraums schnell an ihre Grenzen. So erfordert etwa eine einfache 10×10-Gridworld mit 4 möglichen Aktionen nur 400 Matrixeinträge. Eine moderne Videospielumgebung hingegen erzeugt einen kontinuierlichen Zustandsraum, der eine tabellarische Speicherung völlig unpraktikabel macht.
Um den Algorithmus effektiv zu skalieren, setzen Entwickler auf Funktionsapproximation. Dabei wird die diskrete Q-Tabelle durch eine parametrisierte mathematische Funktion ersetzt, die Q(s,a) kontinuierlich approximiert. Ein Deep Q-Network (DQN) ist der klassische Funktionsapproximator: Es nutzt ein tiefes neuronales Netz, das gezielt darauf trainiert wird, Q-Werte präzise vorherzusagen. Die DQN-Architektur wurde bekanntlich in den fortschrittlichen Atari-Agenten von DeepMind eingesetzt.
Um das instabile Training neuronaler Netze zu stabilisieren, ergänzen moderne DQN-Frameworks zwei zentrale architektonische Komponenten: Ein Experience Replay Buffer bricht systematisch die Korrelation zwischen aufeinanderfolgenden Daten auf, und ein separates Target Network stabilisiert die Zielwerte der Bellman-Gleichung während der Backpropagation.
Welche Anwendungsbereiche und Grenzen hat Q-Learning?
Über akademische Gridworld-Umgebungen hinaus kommen Q-Learning-Algorithmen direkt in verschiedenen Unternehmens- und Industrieanwendungen zum Einsatz, in denen die Ableitung optimaler Strategien von entscheidender Bedeutung ist. Vor dem Schritt in die Produktion müssen Softwareentwickler jedoch die inhärenten algorithmischen Grenzen in Bezug auf Sample-Effizienz und Stationarität der Umgebung sorgfältig berücksichtigen.
Anwendungsfälle in Unternehmen
Q-Learning-Architekturen spielen ihre Stärken gezielt in Umgebungen aus, die komplexe sequenzielle Entscheidungen erfordern. Zu den wichtigsten Anwendungsfällen in der Produktion gehören Agenten für anspruchsvolle Brettspiele, die Steuerung der Telemetrie bei der Navigation von Robotern, komplexe Ressourcenzuweisung sowie die dynamische Optimierung von Netzwerk-Routing. In spezialisierten Unternehmensumgebungen kommen Varianten des Q-Learning in großem Umfang zur Optimierung von Richtlinien für Empfehlungssysteme, zur Durchführung adaptiver Regelkreise und zur Automatisierung dynamischer A/B-Test-Richtlinien zum Einsatz.
Operative Einschränkungen
Trotz seines breiten Anwendbarkeit hat Q-Learning klare operative Grenzen. Die grundlegende Einschränkung bleibt die fehlende Skalierbarkeit der einfachen Q-Tabelle – ein architektonisches Problem, das durch die Migration auf robuste DQN-Architekturen gelöst wird. Darüber hinaus tut sich Q-Learning in Umgebungen mit spärlichen Rewards schwer: Ist das Feedback der Umgebung sehr selten, verlangsamt sich die Konvergenz des Algorithmus erheblich, was häufig fortgeschrittene Reward-Shaping-Techniken erfordert.
Eine weitere wesentliche Einschränkung ist die Sample-Ineffizienz. Einfache Q-Learning-Algorithmen benötigen routinemäßig Millionen einzelner Interaktionen mit der Umgebung, um eine optimale Vorgehensweise zu erlernen, was den Einsatz in realen Production-Umgebungen sehr rechenintensiv macht. Schließlich stellt Nicht-Stationarität ein dauerhaftes operatives Risiko dar: Ändert sich die Dynamik der Umgebung nach dem Training des Agenten erheblich, veralten die statisch gespeicherten Q-Werte schnell, sodass ein konsequentes, regelmäßiges Retraining erforderlich ist, um die operative Genauigkeit zu gewährleisten.
Q-Learning, Modellversionierung und die ML-Pipeline
Eine konvergierte Q-Tabelle oder ein trainiertes Netz ist ein Machine-Learning-Artefakt. Wie jedes Artefakt in der Produktion erfordert es Governance: Versionierung, Scanning und reproduzierbares Deployment. Die Behandlung der Ergebnisse des verstärkenden Lernens nach denselben Grundsätzen der Artefaktverwaltung, die auch bei herkömmlicher Software gelten, ist für reproduzierbare und überprüfbare Deployments absolut unerlässlich.
In modernen Softwareentwicklungs-Workflows muss ein trainierter Q-Learning-Agent explizit als eigenständiges Modellartefakt behandelt werden. Ganz gleich, ob es sich um eine serialisierte Q-Tabelle oder um umfangreiche DQN-Gewichte handelt: Das Artefakt bildet die gelernte Vorgehensweise des Agenten mathematisch ab. Es muss sicher gespeichert, konsequent versioniert und vollständig reproduzierbar gehalten werden.
Experiment Tracking und Model Registries
Die Integration von Q-Learning in einen MLOps-Lebenszyklus auf Unternehmensebene erfordert grundlegend ein präzises Experiment Tracking. ML-Praktiker müssen sämtliche Trainings-Hyperparameter systematisch loggen und dabei Lernrate, Discount-Faktor und die genauen Epsilon-Decay-Schedules sorgfältig festhalten. Spezielle Tracking-Tools erfassen pro Run vollständige Trainingsepisoden, skalare Reward-Kurven und spezifische Konvergenzmetriken.</p<
Eine ML Model Registry auf Unternehmensebene muss diese RL-Agenten anschließend verwalten und die serialisierten Q-Tabelle zusammen mit den expliziten Umgebungskonfigurationen des ursprünglichen Trainingslaufs konsequent versionieren. Eine lückenlose Provenienz der Artefakte – also die Dokumentation, welche Trainingsdatensätze, Versionen des Umgebungs-Frameworks und Hyperparameter-Sets jede einzelne Q-Tabelle-Version erzeugt haben – sorgt für zuverlässig auditierbare Workflows. Wer einen ausgereiften Q-Learning-Agenten in einem Echtzeitsystem betreibt, benötigt dieselbe Latenzoptimierung, dieselbe dynamische Skalierungsinfrastruktur und dieselbe konsequente Monitoring-Disziplin wie bei jedem standardmäßigen Deployment über eine Model Registry.
So unterstützt JFrog Reinforcement-Learning-Workflows
Q-Learning ermöglicht es autonomen Agenten, optimale Entscheidungsrichtlinien abzuleiten, ohne dass sie dafür ein bestehendes dynamisches Umgebungsmodell benötigen. Um diese aufwendig trainierten Agenten effektiv in Produktionssysteme von Unternehmen zu integrieren, sind eine konsequente Artefakt-Governance und vollständig reproduzierbare Deployment-Pipelines unerlässlich, die eine hohe operative Integrität sicherstellen.
Wenn Ihr Unternehmen seine Reinforcement-Learning-Initiativen konsequent skaliert, bringt das zuverlässige Management des komplexen Lebenszyklusses von Q-Tabellen, DQN-Gewichten und Konfigurationen des Umgebungs-Frameworks erhebliche operative Komplexität und Sicherheitsrisiken mit sich. Die JFrog Platform mit JFrog Artifactory und JFrog ML bietet ein universelles Artefakt-Repository und einen umfassenden MLOps-Control-Layer, der Ihre RL-Artefakte zuverlässig absichert und versioniert. JFrog Artifactory dient als universelles Artefakt-Repository und schützt Ihre Q-Tabellen-Binärdateien, Konfigurationsdaten und wichtigen Trainings-Dependencies – mit vollständiger Versionshistorie und auditierbarer Metadaten-Lineage. Darüber hinaus lässt sich JFrog Xray nahtlos in die gesamte Pipeline integrieren und deckt bekannte Schwachstellen in Ihren Python-Packages und spezialisierten ML-Frameworks bereits vor dem Deployment auf.