Claude
 Cursor
 Codex
 Hugging Face
 NVIDIA
 Visual Studio Code
 Devin
 Kiro
 Open Code
 NanoClaw

 Docker
 npm
 PyPy
 Wiz

 Financial Services
 Gaming
 Public Sector
 Automotive
 Technology
 Healthcare


Définition
Le Q-learning est un algorithme d’apprentissage par renforcement (RL) sans modèle qui permet aux agents de déterminer les actions optimales en mettant à jour, de façon itérative, une Q-table des récompenses futures attendues. Cette approche fondée sur la valeur permet aux machines de résoudre des tâches complexes de prise de décision séquentielle sans nécessiter de modèle prédéfini de la dynamique de l’environnement. En s’appuyant sur l’équation de Bellman, les entreprises peuvent élaborer des politiques mathématiquement rigoureuses pour la robotique et l’optimisation réseau, à condition de maintenir une gouvernance stricte de leurs artefacts.
Quelles sont les grandes caractéristiques algorithmiques du Q-learning ?
Le Q-learning se définit par trois grandes caractéristiques algorithmiques :
- Sans modèle : l’algorithme n’a besoin ni d’un modèle de transition complexe ni d’aucune connaissance préalable de la dynamique de l’environnement pour fonctionner.
- Fondé sur la valeur : il fonctionne en optimisant de façon itérative une fonction de valeur discrète, la Q-fonction, afin de dicter strictement le comportement.
- Off-policy : la politique de comportement employée pour explorer l’environnement pendant l’entraînement diffère totalement de la politique de mise à jour qui est apprise et optimisée mathématiquement.
Historiquement, le Q-learning a été introduit par Watkins en 1989. Le Q-learning standard a fourni les mécanismes fondateurs précis qui ont conduit aux avancées modernes de l’apprentissage par renforcement profond, influençant fortement des percées comme AlphaGo et les techniques actuelles d’apprentissage par renforcement à partir de rétroaction humaine (RLHF).
Quelles sont les briques de base du Q-learning ?
Bien comprendre le Q-learning suppose de définir les entités mathématiques et conceptuelles précises qui composent un processus de décision markovien. Ces briques fondamentales fixent les règles du jeu entre l’algorithme d’apprentissage et son environnement opérationnel.
Le cadre mathématique fondamental qui sous-tend le Q-learning porte un nom : le processus de décision markovien (MDP). Un MDP se définit formellement comme un tuple regroupant des états définis, des actions autorisées, des probabilités de transition, des récompenses de l’environnement et un facteur d’actualisation mathématique. Ce cadre repose sur la propriété de Markov, selon laquelle l’état futur dépend strictement de l’état et de l’action actuels, indépendamment de tous les états passés.
Les entités de calcul essentielles
Au sein de ce cadre formalisé, plusieurs entités de calcul essentielles entrent en jeu :
- Agent : l’entité de calcul autonome et décisionnaire qui observe en continu les états et sélectionne les actions correspondantes.
- Environnement : le monde mathématique externe dans lequel l’agent évolue. L’environnement traite les actions et renvoie des récompenses immédiates ainsi que les états qui en découlent.
- État (s) : la situation actuelle, précise et observable, de l’agent dans l’environnement actif.
- Action (a) : le choix précis et discret exécuté par l’agent dans un état donné.
- Récompense (r) : le signal de rétroaction scalaire immédiat renvoyé par l’environnement juste après l’exécution d’une action.
- Épisode : une itération séquentielle complète d’états, d’actions et de récompenses, qui commence à un état initial et se termine à un état final défini.
- Valeur Q (Q(s,a)) : la récompense future cumulée attendue, calculée pour l’exécution de l’action a dans l’état s, en supposant que l’agent suive ensuite la politique optimale.
Comment fonctionne le Q-learning : la règle de mise à jour
L’exécution concrète du Q-learning repose sur une mise à jour mathématique itérative, l’équation de Bellman, qui affine en permanence la valeur attendue des actions. Ce processus dynamique met continuellement en balance la rétroaction immédiate de l’environnement et les bénéfices attendus à long terme des états suivants.
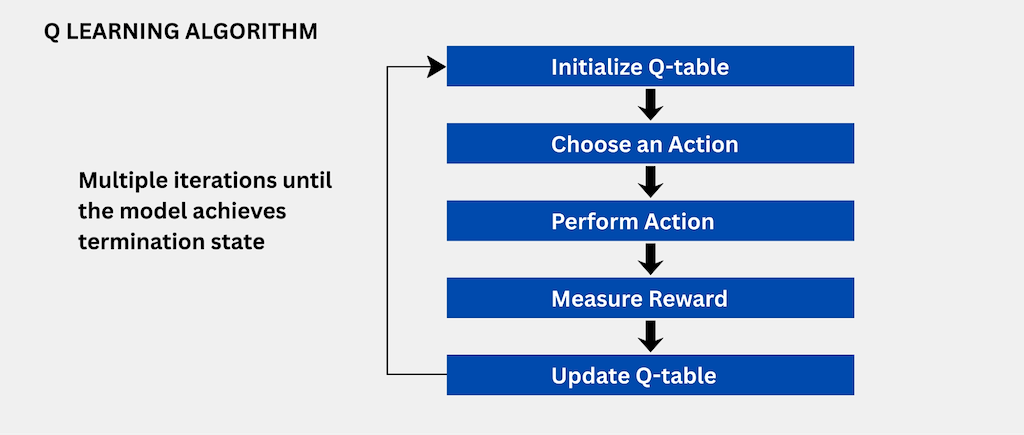
L’algorithme de Q-learning standard stocke systématiquement les valeurs Q apprises dans une structure de données appelée Q-table. Dans une matrice Q-table, les lignes représentent tous les états observables possibles, les colonnes toutes les actions autorisées, et la valeur de chaque cellule contient la récompense future attendue, calculée mathématiquement, pour la paire état-action correspondante. Avant l’entraînement, cette table est généralement initialisée à zéro.
À chaque étape, l’agent observe l’état actuel, choisit une action et reçoit une récompense scalaire accompagnée du nouvel état atteint. L’agent met ensuite à jour la case correspondante de la Q-table à l’aide de la règle de mise à jour de l’équation de Bellman :
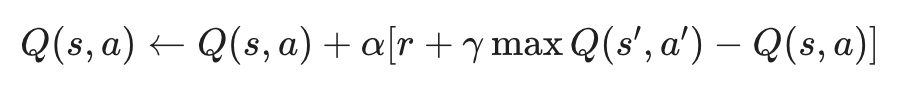
Hyperparamètres et stratégies d’exploration
Tout au long de la phase d’entraînement, l’agent gère stratégiquement le compromis exploration-exploitation grâce à une stratégie ε-greedy. Avec une probabilité ε, l’agent exécute une action totalement aléatoire pour explorer activement l’environnement. À l’inverse, avec une probabilité 1-ε, il choisit l’action dotée de la valeur Q connue la plus élevée afin d’exploiter les connaissances déjà emmagasinées dans sa matrice. Le paramètre ε décroît au fil de l’entraînement, à mesure que les valeurs Q convergent de façon fiable. Pourvu que toutes les paires état-action soient suffisamment explorées, les algorithmes de Q-learning sont mathématiquement garantis de converger vers la politique optimale.
Cette méthode d’apprentissage par différence temporelle repose sur des hyperparamètres finement réglés. Le taux d’apprentissage (a), généralement compris entre 0,1 et 0,7, détermine la vitesse à laquelle les nouvelles informations de l’environnement remplacent les anciennes estimations de valeur. Le facteur d’actualisation (γ), compris entre 0 et 1, détermine l’importance que l’agent accorde aux récompenses futures.
Q-table ou approximation de fonction
Si l’approche tabulaire du Q-learning garantit la convergence dans des environnements finis, elle se heurte à de sévères limites d’évolutivité dès qu’on l’applique à des espaces d’états complexes et de grande dimension. L’approximation de fonction lève cette contrainte en remplaçant la Q-table exhaustive par des modèles paramétrés, comme les réseaux de neurones.
Le principal atout technique d’une Q-table standard réside dans sa simplicité de programmation et sa grande interprétabilité, ainsi que dans ses garanties de convergence absolues au sein de petits environnements discrets. Mais la structure de données Q-table s’effondre rapidement sous l’effet de l’explosion de l’espace d’états. Par exemple, une grille élémentaire de 10 × 10 offrant 4 actions possibles ne requiert que 400 entrées de matrice. À l’inverse, un environnement de jeu vidéo moderne génère un espace d’états continu qui rend tout stockage tabulaire brut totalement ingérable.
Pour faire passer l’algorithme à l’échelle, les ingénieurs recourent à l’approximation de fonction. Cette technique remplace la matrice Q-table discrète par une fonction mathématique paramétrée, conçue pour approximer Q(s,a) de façon continue. Un Deep Q-Network (DQN) fait office d’approximateur de fonction de référence : il s’appuie sur un réseau de neurones profond entraîné à prédire précisément les valeurs Q. L’architecture DQN doit sa notoriété aux agents de DeepMind capables de jouer aux jeux Atari.
Pour stabiliser l’entraînement instable du réseau de neurones, les frameworks DQN modernes introduisent deux ajouts architecturaux déterminants. Un buffer de relecture d’expérience (experience replay) casse systématiquement la corrélation entre les séquences de données, tandis qu’un réseau cible isolé stabilise les cibles de l’équation de Bellman durant la rétropropagation.
Quelles sont les applications et les limites du Q-learning ?
Au-delà des grilles académiques, les algorithmes de Q-learning alimentent directement des applications concrètes, en entreprise comme dans l’industrie, où déterminer la politique optimale est décisif. Reste que les équipes logicielles doivent tenir soigneusement compte des limites propres à l’algorithme, en matière d’efficacité d’échantillonnage et de stationnarité de l’environnement, avant tout passage en production.
Cas d’usage en entreprise
Les architectures de Q-learning excellent avant tout dans les environnements qui exigent une prise de décision séquentielle complexe. Parmi les cas d’usage phares en production : le déploiement d’agents joueurs pour des jeux de plateau avancés, la gestion de la télémétrie de navigation robotique automatisée, l’allocation complexe de ressources ou encore l’optimisation dynamique du routage réseau. Dans des contextes d’entreprise spécialisés, les variantes du Q-learning servent largement à optimiser les politiques des systèmes de recommandation, à piloter des boucles de contrôle de processus adaptatives et à automatiser les politiques de tests A/B dynamiques.
Contraintes opérationnelles
Malgré sa grande utilité, le Q-learning présente des limites opérationnelles bien réelles. La limite fondamentale reste l’incapacité de la matrice Q-table de base à passer à l’échelle, un problème d’architecture que résout naturellement la migration vers des architectures DQN robustes. Le Q-learning peine par ailleurs dans les environnements à récompenses rares : lorsque la rétroaction externe est très peu fréquente, la convergence ralentit fortement et il faut souvent recourir à des techniques avancées de reward shaping pour y remédier.
L’inefficacité d’échantillonnage constitue une autre contrainte majeure. Les algorithmes de Q-learning de base réclament couramment des millions d’interactions avec l’environnement pour apprendre correctement une politique optimale, ce qui les rend très coûteux en calcul dans des conditions de production réelles. Enfin, la non-stationnarité représente un risque opérationnel persistant. Si la dynamique de l’environnement change sensiblement après l’entraînement de l’agent, les valeurs Q stockées deviennent vite obsolètes, imposant des protocoles de réentraînement périodiques rigoureux pour préserver la précision opérationnelle.
Q-learning, versionnage des modèles et pipeline de ML
Une Q-table convergée ou un réseau entraîné est un artefact de machine learning. Comme tout artefact en production, il exige une gouvernance : versionnage, analyse et déploiement reproductible. Appliquer aux productions de l’apprentissage par renforcement la même discipline de gestion des artefacts que pour le logiciel traditionnel est absolument essentiel pour des déploiements reproductibles et auditables.
Dans les workflows de développement logiciel modernes, un agent de Q-learning entraîné doit être explicitement considéré comme un artefact de modèle à part entière. Qu’il s’agisse d’une matrice Q-table sérialisée ou d’un vaste ensemble de poids de réseau DQN, l’artefact généré encode mathématiquement la politique apprise par l’agent. Il doit être stocké de façon sécurisée, rigoureusement versionné et maintenu parfaitement reproductible.
Suivi des expériences et registres de modèles
Intégrer le Q-learning dans un cycle de vie MLOps d’entreprise exige avant tout un suivi précis des expériences algorithmiques. Les praticiens du ML doivent journaliser systématiquement tous les hyperparamètres d’entraînement, en consignant méticuleusement le taux d’apprentissage, le facteur d’actualisation et les calendriers précis de décroissance d’epsilon. Des outils de suivi dédiés capturent l’ensemble des épisodes d’entraînement, les courbes de récompense scalaire et les métriques de convergence propres à chaque exécution.
Un registre de modèles de ML d’entreprise doit ensuite prendre en charge ces agents de RL, en versionnant rigoureusement les Q-tables sérialisées ainsi que les configurations d’environnement utilisées lors de l’entraînement initial. Conserver la provenance exacte des artefacts, en enregistrant précisément quels jeux de données d’entraînement, quelles versions de framework d’environnement et quels jeux d’hyperparamètres ont produit chaque version de Q-table, garantit des workflows réellement auditables. Servir un agent de Q-learning mature dans un système temps réel exige exactement la même optimisation de la latence, la même infrastructure de mise à l’échelle dynamique et la même discipline de monitoring que tout déploiement de Model Registry en production.
Comment JFrog accompagne vos workflows d’apprentissage par renforcement
Le Q-learning permet fondamentalement à des agents autonomes d’élaborer rigoureusement des politiques de décision optimales, sans modèle dynamique de l’environnement préexistant. Mais intégrer efficacement ces agents en production, à l’échelle de l’entreprise, réclame une gouvernance stricte des artefacts et des pipelines de déploiement parfaitement reproductibles pour préserver une intégrité opérationnelle sans faille.
À mesure que votre organisation accélère ses initiatives d’apprentissage par renforcement, gérer de façon fiable le cycle de vie complexe des Q-tables, des poids DQN et des configurations de framework qui en résultent fait naître une réelle complexité opérationnelle et de nouveaux risques de sécurité. La plateforme JFrog, portée par JFrog Artifactory et JFrog ML, offre un dépôt d’artefacts universel et une couche de contrôle opérationnel MLOps complète qui sécurise et versionne vos artefacts de RL en toute fiabilité. JFrog Artifactory joue le rôle de dépôt d’artefacts universel : il sécurise vos fichiers binaires de Q-table, vos données de configuration et les packages de dépendances essentiels à l’entraînement, avec un historique de versions complet et une traçabilité auditable des métadonnées. Et pour aller plus loin, JFrog Xray s’intègre en toute fluidité tout au long du pipeline pour détecter les vulnérabilités connues dans vos packages Python et vos frameworks de ML avant même le déploiement.