Claude
 Cursor
 Codex
 Hugging Face
 NVIDIA
 Visual Studio Code
 Devin
 Kiro
 Open Code
 NanoClaw

 Docker
 npm
 PyPy
 Wiz

 Financial Services
 Gaming
 Public Sector
 Automotive
 Technology
 Healthcare


Warum Modell-Routing nach hinten losgeht und wie Sie Agenten entwickeln, die Ihr Budget nicht sprengen
Von
8 min read
Modell-Routing verspricht, Ihre Ausgaben für KI-Agenten zu senken, indem Routineaufgaben an günstigere Modelle wie Claude Haiku ausgelagert werden, während Frontier-Modelle wie Claude Sonnet für komplexe Aufgaben verwendet werden. Mit der richtigen Konfiguration können Routing-Strategien die Inferenzkosten um 40–85 % senken. Wird das Routing in einem Multi-Turn-Agenten jedoch falsch implementiert, können am Ende höhere Kosten entstehen, als wenn Sie ganz darauf verzichtet hätten. Hier erfahren Sie, warum das so ist und wie Sie das Problem beheben können.
Wie sich Token-Kosten über eine Session hinweg aufsummieren
Um zu verstehen, warum Routing nach hinten losgehen kann, muss man zunächst verstehen, warum die Kosten bei Agentic Sessions schnell steigen. Mit jedem weiteren „Turn“ in der Interaktion wächst die Zahl der Token – und genau dieser kumulative Effekt ist die treibende Kraft sowohl für mögliche Einsparungen als auch für das Kostenrisiko.
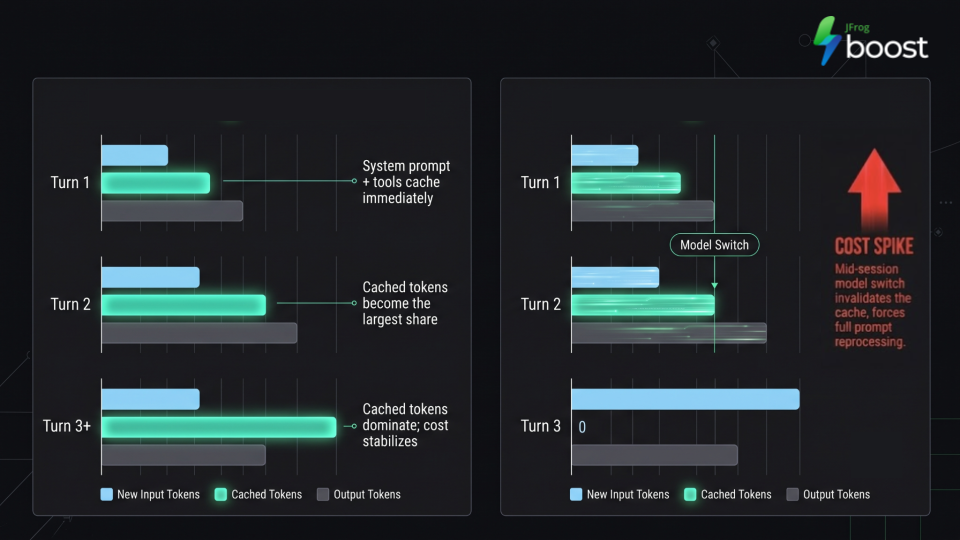
Mit jedem Turn in einer Agentensitzung wächst die Tokenmenge. Die folgende Tabelle zeigt, wie sich deren Verteilung im Verlauf einer typischen Sitzung mit drei Turns verändert:
| Turn | Neue Input-Token | Zwischengespeicherte Token |
| Turn 1 | Hoch (Basismeldung) | Keine |
| Turn 2 | Niedrig (Folgenachricht) | Hoch (alles aus Turn 1) |
| Turn 3+ | Minimal | Sehr hoch (kumulativ) |
Ab dem dritten Turn machen zwischengespeicherte Token den Großteil Ihrer gesamten Tokenmenge aus. Genau diesen Effizienzvorteil gilt es zu erhalten. Ein Modellwechsel während einer laufenden Sitzung macht ihn jedoch vollständig zunichte.
Warum steigen die Kosten, wenn Sie während einer Sitzung das Modell wechseln?
Ein Wechsel des LLM-Modells mitten in der Sitzung macht die zuvor erzielten Einsparungen durch Prompt-Caching zunichte. Der Grund ist, dass der Cache eines Anbieters jeweils an ein bestimmtes Modell gebunden ist. Das neue Modell hat keinen Zugriff auf den gespeicherten Verlauf des vorherigen Modells und muss daher die gesamte bisherige Konversation erneut zum regulären Preis für Input-Token verarbeiten.
Prompt-Caches basieren auf Prefix Matching (Präfixabgleich). Der LLM-Anbieter speichert einen Hash Ihres Nachrichtenpräfixes. Solange das Präfix gleich bleibt und weiterhin dasselbe Modell verwendet wird, profitiert jeder weitere Turn von deutlich günstigeren Preisen für gecachte Token. Anthropic bietet beispielsweise bis zu 90 % Rabatt auf zwischengespeicherte Input-Token. Sobald Sie jedoch das Modell wechseln, startet das neue Modell mit einem leeren Cache (Cold Cache). Es verarbeitet den gesamten bisherigen Gesprächsverlauf zu den vollen Kosten für Input-Token, als hätte Turn 1 nie stattgefunden. Bei kurzen Sitzungen fällt das kaum ins Gewicht. Bei agentischen Coding-Workflows mit Kontextfenstern von 50.000 Token oder mehr kann jedoch bereits ein einziger Modellwechsel während der Sitzung die Kosten so stark in die Höhe treiben, dass die durch das Routing erhofften Einsparungen vollständig aufgezehrt werden.
Was Sie vermeiden sollten
Mehrere gängige Routing-Muster wirken auf den ersten Blick wie Optimierungen, können Ihre Kosten jedoch erhöhen. Dies sind die häufigsten Ursachen für unerwartete Kostensteigerungen in Agentensystemen im Produktivbetrieb:
- Das Modell mitten in einer langen Konversation wechseln, ohne den bisherigen Verlauf zusammenzufassen. Dadurch muss das neue Modell den gesamten Konversationsverlauf erneut zum vollen Preis für Input-Token verarbeiten. Die Cache-Miss-Kosten für eine Sitzung mit 20.000 Token können höher sein als die Einsparungen, die durch den Wechsel erzielt werden sollten.
- Auto-Routing während einer laufenden Sitzung in LLM-Gateways aktivieren LLM-Gateway-Tools wie LiteLLM, OpenRouter und Portkey unterstützen automatisches Routing basierend auf der Komplexität einer Anfrage. Für Single-Turn-Abfragen bietet das klare Vorteile. Wird Auto-Routing jedoch innerhalb eines Agentic Loops während einer laufenden Sitzung eingesetzt, wird der KV-Cache an jeder Routing-Grenze ungültig.
- Tools oder System-Prompts während einer Sitzung ändern Tool-Definitionen befinden sich im gecachten Präfix. Das Hinzufügen oder Entfernen eines Tools während einer Sitzung macht den gesamten Cache nach dieser Änderung ungültig. Behandeln Sie die Tool-Konfiguration einer Sitzung nach ihrem Start als unveränderlich.
- Compression Calls mit einem separaten Modell durchführen Viele Agenten komprimieren lange Gesprächsverläufe, indem sie mit einem günstigeren Modell eine Zusammenfassung erstellen lassen. Verwendet dieser Aufruf jedoch ein anderes Modell oder einen anderen System-Prompt, führt das zu einem eigenen Cache-Miss und bei der Rückkehr zur Hauptsitzung wird deren Cache zurückgesetzt.
Um dieser Muster zu vermeiden, braucht es ein gezieltes Session-Design und nicht nur eine korrekte Routing-Logik. Ihre Routing-Strategie ist nur so gut wie Ihre Sitzungsarchitektur.
Best Practices: So machen Sie es richtig
Effektives Modell-Routing in Agentic Systems muss auf Sitzungsebene und nicht auf Ebene einzelner Anfragen betrachtet werden. Mit den folgenden Praktiken können Sie die Kostenvorteile des Routings nutzen, ohne die Einsparungen durch den Prompt-Cache zu opfern, die agentische KI wirtschaftlich tragfähig machen:
- Anzahl der Interaktionen pro Aufgabe minimieren und früh delegieren Halten Sie einzelne Agentensitzungen so kurz wie möglich. Wenn Sie wissen, dass eine Aufgabe umfangreichen Kontext erfordert (z. B. ein komplexes Refactoring über mehrere Dateien, eine lang laufende Compliance-Prüfung), delegieren Sie sie gleich zu Beginn an einen Subagenten, bevor sich in der Sitzung ein Verlauf ansammelt. Kurze Sitzungen bedeuten kleine Caches, wodurch ein Modellwechsel weniger kostet.
- Das Subagenten-Muster für Modellvielfalt nutzen Anstatt Modelle innerhalb einer einzelnen Sitzung zu wechseln, erstellen Sie einen orchestrierenden Agenten, der Teilaufgaben an speziell ausgelegte Subagenten delegiert. Jeder Subagent startet neu, verfügt nur über den benötigten Kontext und läuft auf dem Modell, das für seine spezifische Aufgabe am besten geeignet ist. Keine Cache-Invalidierung. Keine Nachteile durch angesammelten Verlauf. Dieses Muster (manchmal als Orchestrator-Subagenten-Architektur bezeichnet) ist der sauberste Weg, Modell-Diversität kostenoptimiert zu nutzen, ohne den Nachteil eines Wechsels während einer Sitzung in Kauf zu nehmen.
- Vor jedem erforderlichen Modellwechsel gezielt zusammenfassen Wenn ein Modellwechsel während einer Sitzung unvermeidbar ist, erstellen Sie eine strukturierte Übergabe: Fassen Sie den aktiven Kontext, den aktuellen Aufgabenstatus und alle offenen Entscheidungen ausdrücklich in einer kompakten Nachricht zusammen. Starten Sie mit dem neuen Modell eine neue Sitzung und verwenden Sie nur diese Zusammenfassung als Eingabe. Sie zahlen die normalen Input-Kosten für eine kleine Zusammenfassung statt gecachter Kosten für die erneute Verarbeitung eines Verlaufs mit 20.000 Token.
- Sitzungskonfiguration festlegen System-Prompts, Tool-Definitionen und die Modellauswahl sollten zu Beginn der Sitzung festgelegt werden. Behandeln Sie sie wie ein Schema: Sie während einer Sitzung zu ändern, ist ein Migrationsereignis und keine Konfigurationsanpassung. Wenn Ihr Agenten-Framework dynamisches Laden von Tools erlaubt, prüfen Sie, wo und wann diese Ladevorgänge im Verhältnis zu Ihrer Cache-Präfixgrenze stattfinden.
Wie JFrog Boost Ihre Cache-Effizienz automatisch schützt
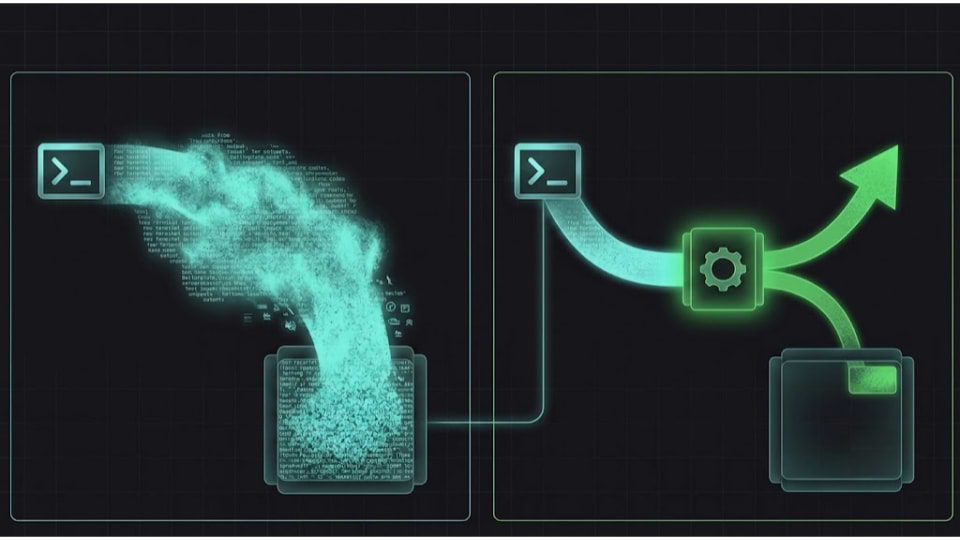
Während die Verwaltung der Modell-Routing-Logik entscheidend für den nachhaltigen Einsatz von Agents ist, verstärkt ein aufgeblähter Kontext die Token-Verschwendung erheblich. Jedes Mal, wenn ein Agent einen Build ausführt, eine Testsuite startet oder Logs abruft, gelangen Hunderte Zeilen sich wiederholender Terminal-Ausgaben in den Konversationsverlauf.
In einer Multi-Turn-Sitzung wächst diese Datenmenge schnell an. Aus einem eigentlich schlanken Verlauf kann so innerhalb weniger Gesprächsschritte eine Tokenmenge von 50.000 entstehen. Das wirkt sich direkt auf Ihr Cost Engineering aus: Ist die Sitzung mit Terminal-Ausgaben überladen, werden die zuvor beschriebenen Mehrkosten eines Cache-Miss bei einem Modellwechsel während der Sitzung umso höher.
Beim Einsatz von Coding-Agenten sollten Entwickler Terminal-Ausgaben nicht manuell kuratieren müssen, nur um zu verhindern, dass ein umfangreicher Build-Schritt die LLM-Kosten in die Höhe treibt.
JFrog Boost wurde entwickelt, um genau diesen Kontext-Bloat direkt im Entwickler-Workflow zu lösen. Boost ist ein schlankes CLI-Tool, das Terminal-Ausgaben während Agentic Loops intelligent komprimiert, indem es sich wiederholende Boilerplate entfernt, während wichtige Informationen wie exakte Error-Stack-Traces vollständig erhalten bleiben. Anstatt Tausende von Token roher Build-Logs an das Modell zu senden, reduziert Boost die Payload, noch bevor die Daten den Agenten erreichen.
Indem Boost Ihren Sitzungsverlauf schlank hält, reduziert es die Anzahl der Token, die pro Turn standardmäßig verarbeitet werden, deutlich. Dadurch sinken die zusätzlichen Kosten unvermeidbarer Modell-Routing-Wechsel, das verfügbare Kontextfenster kann länger genutzt werden und die Kosteneffizienz des Prompt-Caching wird maximiert.
Eine nachhaltige Agent-Ökonomie schaffen
Modell-Routing kann erhebliche Kosteneinsparungen ermöglichen – allerdings nur, wenn die zugrundeliegenden Mechanismen der Prompt-Caches der Anbieter berücksichtigt werden. Für nachhaltige Agenten-Workflows sollten Sie Ihren Gesprächsverlauf als konsequent zu optimierendes Asset behandeln: Halten Sie Ihre primären Sitzungen schlank, delegieren Sie umfangreichen Kontext an kurzlebige Subagenten und stellen Sie sicher, dass jeder notwendige Modellwechsel über eine strukturierte Zusammenfassung des aktuellen Status erfolgt, anstatt den gesamten bisherigen Verlauf erneut zu verarbeiten.
Letztlich erfordert die Entwicklung nachhaltiger agentischer Systeme, die Token-Effizienz ebenso als zentrale Anforderung zu behandeln wie Geschwindigkeit und Genauigkeit.
Um diese Optimierungen auf Sitzungsebene automatisch zu implementieren und unnötigen Kontext in Ihren Entwicklungs-Workflows zu vermeiden, können Sie Boost installieren und noch heute damit beginnen, Token einzusparen.
Kontaktieren Sie uns
Wir würden uns freuen, mehr über Ihre Erfahrungen, Architektur-Ansätze und Herausforderungen beim Modell-Routing zu erfahren. Kontaktieren Sie uns gerne oder bleiben Sie über unsere laufende Forschung zu Coding Agents jederzeit auf dem Laufenden:
→ X: https://x.com/ShayFrektman, https://x.com/yahav_ohana
→ LinkedIn: https://www.linkedin.com/in/shay-dahan, https://www.linkedin.com/in/yahav-ohana/
→ Substack: https://substack.com/@yahavohana
See what JFrog & GitHub can do together